RACE-model voor ChatGPT-prompts: het sjabloon met voorbeelden
Het RACE-model als promptsjabloon: Role, Action, Context en Execute (of Expectation), met ingevulde voorbeelden per marketingtaak en de valkuilen

Samenvatting
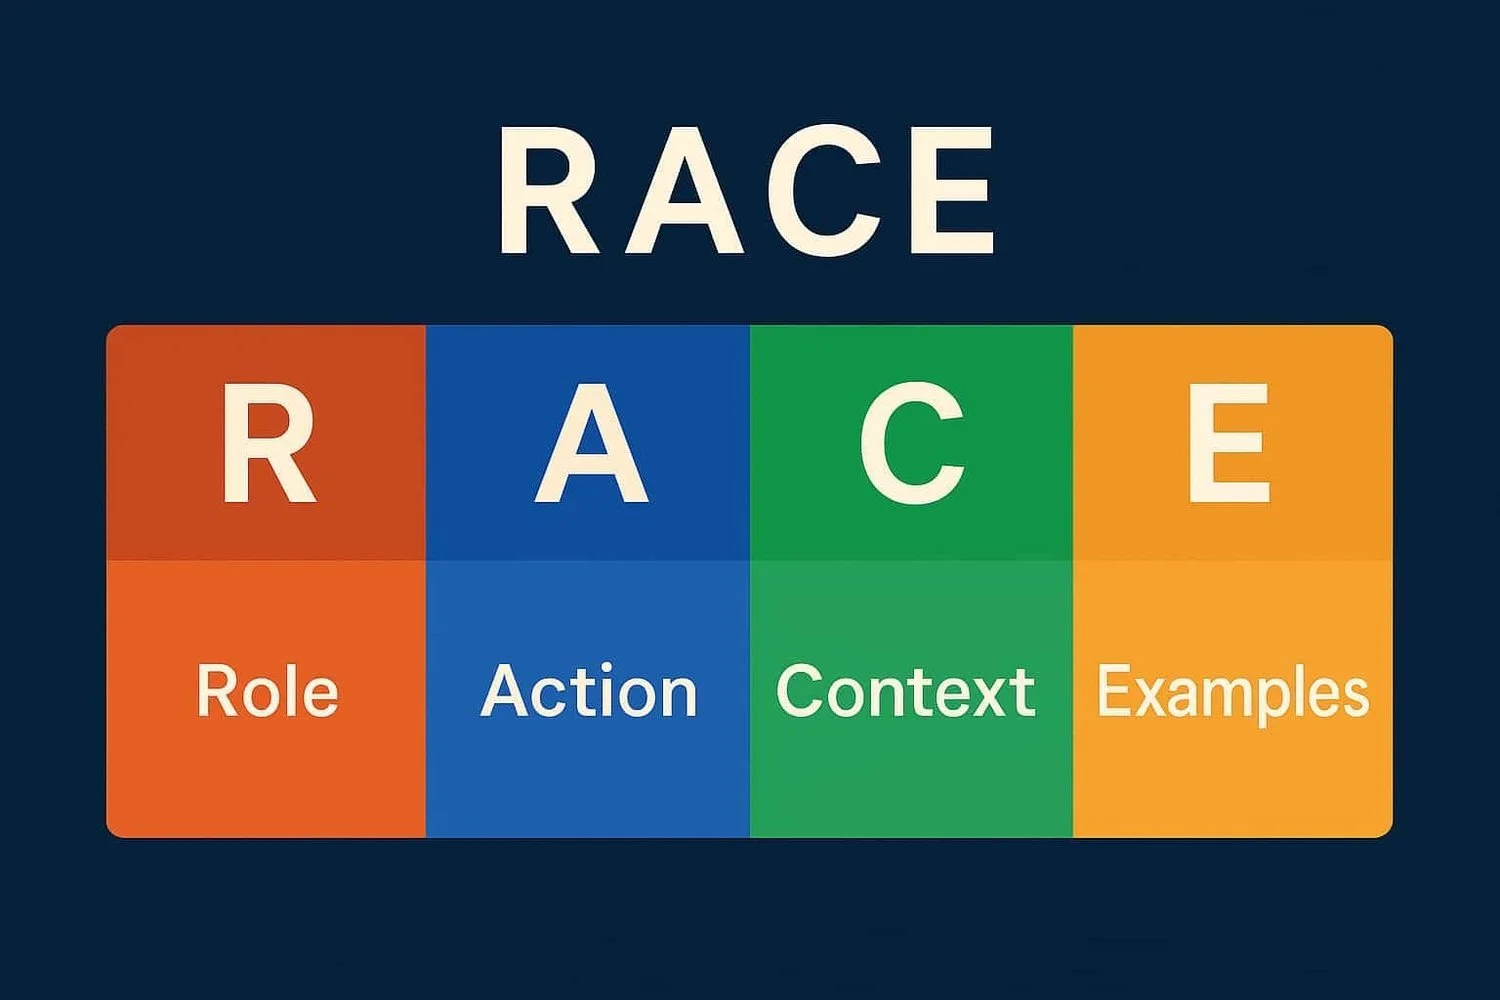
- RACE is een promptsjabloon in 4 vaste blokken: Role, Action, Context en Execute, in die volgorde in één prompt
- De oudste gedateerde bron is Trust Insights (eerste vermelding juli 2023, Execute voluit vanaf september 2023); Expectation verscheen in augustus 2023 en Examples later, beide zonder vaste bron, en een officiële definitie bestaat niet
- Let op de naamsverwarring: in marketing staat RACE meestal voor Reach, Act, Convert, Engage, een planningsmodel dat niets met prompts te maken heeft
- Een rol stuurt toon en gedrag, maar maakt antwoorden niet juister: onderzoek van Wharton en van Zheng en collega's vond geen winst in feitelijke juistheid
- Google en Anthropic raden voorbeelden standaard aan, Anthropic 3 tot 5 per prompt: zet ze als apart blok na Execute
- Kopieerbare sjablonen per marketingtaak, plus een werkwijze voor teams: vaste rol en context in projectinstructies, de taak in de prompt
Het RACE-model is een vast stramien om een ChatGPT-prompt op te bouwen in 4 blokken: Role, Action, Context en Execute. Wie het opzoekt, botst al snel op twee verwarringen. In marketing staat RACE meestal voor een planningsmodel dat niets met prompts te maken heeft, en binnen de promptwereld circuleren er drie invullingen van de laatste letter. We zetten de herkomst eerlijk op een rij en geven daarna waar je voor komt: een sjabloon om te kopiëren, ingevuld voor de marketingtaken die bij een KMO elke week terugkomen, met de valkuilen en een werkwijze voor je team. De basis van een goede prompt herhalen we hier niet. Die staat in onze gids over betere prompts schrijven, de technieken daarna in prompt engineering voor gevorderden.
Waar staat het RACE-model voor bij ChatGPT-prompts?
RACE staat voor Role, Action, Context en Execute: de rol die de AI aanneemt, de taak die je vraagt, wat het model over jouw situatie moet weten en in welke vorm het antwoord moet komen. Je schrijft die 4 blokken onder elkaar in één prompt. Het kader komt uit de praktijk van een analytics- en AI-adviesbureau en heeft geen academische oorsprong.
| Blok | Vraag die je beantwoordt | Voorbeeld van een regel |
|---|---|---|
| Role | Wie moet de AI zijn? | “Je bent copywriter met ervaring in B2B-software.” |
| Action | Wat moet er gebeuren? | “Schrijf een opvolgmail voor prospects die niet reageerden.” |
| Context | Wat moet hij weten om het goed te doen? | “Doelgroep, product, tone of voice, wat er al gestuurd is.” |
| Execute | Hoe moet het antwoord eruitzien? | “Maximaal 130 woorden in lopende tekst, met 3 onderwerpregels.” |
De oudste gedateerde bron die we vonden, is Trust Insights, het bureau van Christopher Penn en Katie Robbert in Boston. Hun nieuwsbrief verwijst op 12 juli 2023 naar “the RACE prompt structure we recommend” en schrijft het op 6 september 2023 voluit als Role, Action, Context, Execute. Trust Insights presenteert RACE als eigen kader, gebaseerd op de documentatie van de bedrijven achter de taalmodellen. Dat het bureau de bedenker is, blijft hun eigen claim: het is de vroegste datering die we vonden, geen sluitend bewijs dat er niets ouder bestaat.
Intussen bracht Trust Insights een uitgebreidere opvolger uit, RAPPEL (oktober 2024), en een versie voor redeneermodellen (april 2025). Het origineel schuiven ze daarbij zelf niet af:
“So, the original RACE framework was role, action, context, execute, which, by the way, still works, to be clear.”
— Christopher S. Penn, medeoprichter van Trust Insights, in de podcast In-Ear Insights (oktober 2024)
Dat maakt RACE een goed instapkader. ClickForest werkt in zijn AI-opleidingen voor KMO’s in Vlaanderen met sjablonen zoals dit, omdat 4 blokken makkelijk te onthouden zijn en een team snel op hetzelfde niveau brengen.
Let op met de naam. Wie in een marketingcontext over het RACE-model spreekt, bedoelt vaak het planningsmodel van Smart Insights: Reach, Act, Convert, Engage, een indeling van de klantreis van Dave Chaffey die niets met AI-prompts te maken heeft. Zelfde 4 letters, ander vakgebied. Wij hebben het hier consequent over het promptkader; het planningsmodel hoort thuis in een gesprek over online marketing en kanaalstrategie.
Waar staat de E in RACE voor?
De E staat voor Execute bij Trust Insights, de oudste bron die RACE noemt, en voor Expectation in de versie die je in zoekresultaten en cursusmateriaal het vaakst ziet. Een derde variant gebruikt Examples. Alle drie vullen hetzelfde slotblok: wat je van het antwoord verwacht en hoe het eruit moet zien. Een officiële definitie die de knoop doorhakt, bestaat niet.
Zo liepen de varianten uiteen:
- Execute (september 2023): de versie van Trust Insights, het bureau dat RACE al in juli 2023 noemde. Het bureau is zelf niet consequent. Het schrijft ook “Execution”, en in een nieuwsbrief van april 2025 omschrijft het die E als “tell the model what you expect for outcomes”, wat dicht bij Expectation ligt. Ayse Ozturk vat Execute in 2025 samen als “Specify the output style”.
- Expectation (augustus 2023): de vroegste vindplaats is een LinkedIn-artikel van Edi Hezri Hairi van 3 augustus 2023 met 9 promptkaders, zonder bronvermelding van het kader. Daar staat bij Expectation: “Describe the expected outcome.” Dat lijstje is veel gekopieerd. Of Expectation van Trust Insights afstamt of los ontstond, valt niet vast te stellen. Fabio Vivas gaf het in 2025 een zinsjabloon: “As a [Role], [Action] considering [Context]. I expect [Expectation].”
- Examples (2024): onder meer Side School gebruikt het slotblok voor “good examples of structures we would like to reproduce”. Waar die variant vandaan komt, konden we niet achterhalen.
In het sjabloon houden we Execute aan, omdat een instructie over vorm en formaat in bijna elke taak nodig is. Zoek je op “role action context expectation”, dan verlies je met dit sjabloon niets: beschrijf in het slotblok het resultaat dat je verwacht samen met de vorm, en je hebt dezelfde prompt. Voorbeelden voegen we toe als apart blok na Execute, zodat wie de Examples-variant kent ook aan zijn trekken komt. Hoe dat gaat, staat verderop.
Hoe ziet een RACE-prompt er concreet uit?
Als 4 gelabelde blokken onder elkaar, elk beginnend met de naam van het onderdeel. De labels dwingen je om niets over te slaan en maken de prompt herbruikbaar, want je vervangt enkel de invulvelden. Ze helpen ook het model: volgens OpenAI bakenen koppen en lijsten de verschillende delen van een prompt af. Dit is het lege sjabloon:
Role: Je bent [functie of expertise] met ervaring in [sector of domein].
Action: [Werkwoord] [wat precies] voor [wie].
Context: Wij zijn [bedrijf of product]. Doelgroep: [omschrijving].
         Tone of voice: [omschrijving]. Wat je moet weten: [feiten, cijfers,
         beperkingen, wat er al gebeurd is, waarom deze taak belangrijk is].
Execute: [Lengte en taal]. [Structuur: alinea's, kop, tabel, aantal varianten].
         [Hoe het moet klinken, in positieve termen].
         Vermijd daarnaast: [specifieke woorden of elementen die er niet in mogen].
Let op de volgorde in het Execute-blok. Eerst beschrijf je wat je wél wil, pas daarna wat er niet in mag. Anthropic raadt dat expliciet aan: “Tell Claude what to do instead of what not to do”. Een model weet beter wat te doen met “schrijf in lopende alinea’s” dan met “gebruik geen opsommingen”.
En zo ziet het eruit als je het invult voor een concrete taak:
Role: Je bent copywriter met ervaring in B2B-software voor productiebedrijven.
Action: Schrijf een opvolgmail naar prospects die vorige maand ons webinar
        volgden maar nog geen demo boekten.
Context: Wij verkopen planningssoftware aan productiebedrijven met 50 tot 250
         medewerkers. De ontvanger is productieverantwoordelijke, geen IT'er.
         Zijn grootste frustratie is plannen in Excel en elke week opnieuw
         schuiven. Het webinar ging over planningsfouten die geld kosten.
         Deze mail moet het gesprek heropenen, nog niet verkopen.
         Tone of voice: nuchter en concreet, zoals een collega uit de sector.
Execute: Maximaal 130 woorden, in het Nederlands, in korte alinea's lopende
         tekst, met 3 onderwerpregels om uit te kiezen. Noem één concreet
         planningsprobleem uit het webinar en sluit af met één vraag die
         met ja of nee te beantwoorden is.
         Vermijd daarnaast: het woord "oplossing" en een lijst van features.
Het verschil met “schrijf een opvolgmail over ons webinar” is groot. Met die korte vraag kan het model alleen een gemiddelde e-mail schrijven; de ingevulde versie geeft het genoeg om iets te maken dat op jouw bedrijf lijkt. Werk je in Claude, dan kun je de blokken ook afbakenen met XML-tags zoals <context> en </context>, wat Anthropic aanraadt om instructies, context en voorbeelden uit elkaar te houden. De labels van RACE doen hetzelfde in gewone taal.
Welke RACE-sjablonen kun je meteen kopiëren?
Hieronder 6 sjablonen voor terugkerende marketingtaken: productbeschrijving, LinkedIn-post, opvolgmail, advertentietekst, reviewanalyse en blogbriefing. Vervang de blokhaken door je eigen gegevens en laat de labels staan. Ze zijn bewust compact gehouden. Het Contextblok mag bij jou gerust 3 keer zo lang worden, want daar komt de kwaliteit vandaan.
| Taak | RACE-sjabloon |
|---|---|
| Productbeschrijving | Role: copywriter voor een webshop in [sector]. Action: schrijf een productbeschrijving voor [product] gericht op [doelgroep]. Context: [wat het product doet], [waarom klanten twijfelen], tone of voice [omschrijving]. Execute: 120 woorden, openingszin plus 3 concrete voordelen plus afsluiter, in een nuchtere toon die feiten laat spreken. |
| LinkedIn-post | Role: contentverantwoordelijke van [bedrijf]. Action: schrijf 3 varianten van een post over [onderwerp]. Context: doelgroep [functie en sector], wat wij erover te zeggen hebben: [standpunt of ervaring]. Execute: max 120 woorden per variant, elk met een andere opening (vraag, cijfer, anekdote), eindigend op een vraag aan de lezer. Vermijd daarnaast hashtags. |
| Opvolgmail | Role: [jouw functie] bij [bedrijf]. Action: schrijf een opvolgmail naar [type contact] die [situatie]. Context: eerdere contactmomenten [omschrijving], hun bezwaar is vermoedelijk [bezwaar], tone of voice [omschrijving]. Execute: max 130 woorden, ik-vorm, 3 onderwerpregels, afsluiten met één vraag. |
| Advertentietekst | Role: performance-copywriter. Action: schrijf 5 advertentiekoppen en 2 beschrijvingen voor [campagne]. Context: aanbod [omschrijving], doelgroep [omschrijving], wat ons onderscheidt: [punt]. Execute: koppen max 30 tekens, beschrijvingen max 90 tekens, in het Nederlands, elke kop met een ander voordeel. |
| Reviewanalyse | Role: marketinganalist. Action: analyseer onderstaande klantreviews en haal de terugkerende patronen eruit. Context: wij zijn [type zaak], we willen weten [vraag]. Reviews: [plak hier]. Execute: 5 patronen in een tabel, elk met een citaat uit de data en één actie die wij kunnen nemen. |
| Blogbriefing | Role: contentstrateeg. Action: maak een artikelbriefing over [onderwerp]. Context: doelgroep [omschrijving], zoekintentie [informatief of commercieel], wat wij al gepubliceerd hebben: [links]. Execute: werktitel, 6 tot 8 H2’s als vraag, per H2 2 zinnen richting, plus 5 vragen voor de FAQ. |
Voor de inhoud achter de LinkedIn-post en de advertentietekst vind je de strategische kant in onze artikels over LinkedIn-marketing voor B2B-leads en Google Ads optimaliseren.
Hoe scherp je Role, Action, Context en Execute aan?
Per blok geldt een eigen vuistregel: houd de rol geloofwaardig, maak de actie meetbaar, vul de context aan tot een nieuwe collega ermee vooruit kan, en beschrijf de vorm zo dat je het resultaat kunt afvinken. De meeste teleurstellende output is te herleiden tot één blok dat te dun is ingevuld, en dat is bijna altijd Context.
Role: toon en invalshoek
Kies een rol die past bij het perspectief dat je zoekt (“copywriter voor webshops in de tuinsector”), en reken er niet op voor kennis. Zheng en collega’s testten 162 rollen op 2.410 feitelijke vragen bij 4 modelfamilies en vonden dat een persona in de systeemprompt de prestaties niet verbetert. Wharton Generative AI Labs bevestigde dat in december 2025 op 6 recentere modellen van OpenAI en Google: een expertrol maakte de antwoorden niet juister. Een rol uit het verkeerde vakgebied liet een van de Gemini-modellen zelfs geregeld weigeren om te antwoorden.
“For factual work, it doesn’t really matter, so don’t overcomplicate it”
— Lennart Meincke, research fellow aan het Mack Institute for Innovation Management van Wharton, in Knowledge at Wharton (april 2026)
Wat een rol wel doet, is gedrag en toon sturen. Anthropic schrijft: “Setting a role in the system prompt focuses Claude’s behavior and tone for your use case.” Ook de Wharton-onderzoekers zien waarde in een rol om perspectief en toon te bepalen. Gebruik Role dus voor stem en invalshoek, en zet de kennis die het antwoord nodig heeft zelf in Context. Een rol die bij elke taak terugkomt, hoort in de systeemprompt, waar Anthropic, Google en OpenAI hem alle drie aanraden, of in de projectinstructies van je assistent. Eén kanttekening: beide studies testten feitelijke vragen. Wat een rol doet voor een marketingtekst, is niet onderzocht.
Action: één taak, één werkwoord
Eén taak per prompt, met een werkwoord vooraan. Een e-mail, 3 posts en een analyse in één prompt leveren zelden 3 bruikbare resultaten op. Splitsen is bijna altijd sneller dan herwerken. Maak de taak ook meetbaar: “schrijf 5 koppen” is te controleren, “schrijf iets pakkends” niet.
Context: het blok dat het verschil maakt
Doelgroep, aanbod, tone of voice, wat er al gebeurd is, wat niet mag, en waarom de taak ertoe doet. Een goede test: zou een freelancer met deze briefing kunnen starten zonder terug te bellen? Anthropic gebruikt hetzelfde beeld: het omschrijft Claude als een briljante maar nieuwe medewerker die jouw normen en werkwijze nog niet kent.
Anthropic raadt ook aan om de reden achter een instructie mee te geven, omdat het model zo je doel beter begrijpt. Daarom staat in het sjabloon “waarom deze taak belangrijk is” bij Context. Google zegt over context hetzelfde: “This contextual information helps the model understand the constraints and details of what you’re asking for it to do.”
Execute: eerst wat je wil
Lengte, taal, structuur, aantal varianten en toon, geformuleerd als wat je wil zien. Verbodsregels zet je erachter als aanvulling, voor een specifiek woord of element dat er echt niet in mag. Hoe preciezer het blok, hoe makkelijker je het resultaat afvinkt zonder discussie.
En bij redeneermodellen?
Modellen die eerst nadenken voor ze antwoorden, vragen een iets andere aanpak. OpenAI schrijft: “reasoning models will provide better results on tasks with only high-level guidance. This differs from GPT models, which benefit from very precise instructions.” Trust Insights paste RACE daar in april 2025 op aan: laat het model zelf een rol kiezen, laat het nadenken over wat het doet en waarom, en geef het grondig bronmateriaal als context. Hun samenvatting: “We still have to tell them what to do and why to do it, but we now leave how to do it up to them.” Bij een redeneermodel houd je Action en Context dus even scherp, en mag Execute meer over het doel gaan dan over elk detail van de vorm.
Wanneer voeg je voorbeelden toe aan je RACE-prompt?
Bij elke taak waarvan je de toon of vorm moeilijk in woorden vat, en volgens Google eigenlijk bijna altijd. Twee alinea’s die je goed vindt, zeggen meer dan 10 adjectieven. Volgens Anthropic haal je met 3 tot 5 voorbeelden het beste resultaat; met te veel voorbeelden gaat het model ze volgens Google te letterlijk navolgen. Zet ze als apart blok na Execute.
“We recommend to always include few-shot examples in your prompts. Prompts without few-shot examples are likely to be less effective.”
— Google, Gemini API-documentatie Prompt design strategies (geraadpleegd oktober 2026)
Die techniek heet few-shot prompting, en het is precies waar de Examples-variant van RACE naar verwijst. Ze loont vooral bij tone of voice, bij een vast formaat dat lastig te beschrijven is (een productfiche, een rapportageblok) en bij classificatietaken, waar een voorbeeld per categorie het model meteen op het juiste spoor zet. Kies voorbeelden die van elkaar verschillen: OpenAI raadt aan “a diverse range of possible inputs with the desired outputs” te tonen. Zo pikt het model het gemeenschappelijke patroon op.
Baken het blok duidelijk af, zodat het model weet waar de voorbeelden beginnen en eindigen:
Voorbeelden:
<voorbeeld>
[een productbeschrijving die je goed vindt]
</voorbeeld>
<voorbeeld>
[een tweede, voor een ander type product]
</voorbeeld>
Schrijf in de stem en opbouw van deze voorbeelden. Neem er geen zinnen of feiten uit over.
Die laatste regel is belangrijk: zonder die regel neemt een model soms formuleringen of productdetails letterlijk over. De bredere set technieken, van voorbeelden meegeven tot stap voor stap laten redeneren, behandelen we in ons artikel over prompt engineering. Een korte definitie van de term staat in de woordenlijst.
Hoe verhoudt RACE zich tot CO-STAR, CREATE en RISEN?
Van deze 4 kaders is RACE het kortste. CO-STAR en CREATE geven een eigen blok aan zaken die RACE onder Context of Execute laat vallen, zoals doelgroep, toon of voorbeelden. We vonden geen bron die aantoont dat één kader betere output oplevert dan een ander. Kies dus het kader dat je team ook echt volledig invult.
| Kader | Letters | Herkomst | Wat het apart benoemt |
|---|---|---|---|
| RACE | Role, Action, Context, Execute | Trust Insights, gedateerd vanaf juli 2023 | Het minimum: rol, taak, context en vorm |
| CO-STAR | Context, Objective, Style, Tone, Audience, Response | Gebruikt door GovTech Singapore in zijn Prompt Engineering Playbook | Stijl, toon en doelgroep elk als eigen blok |
| CREATE | Character, Request, Examples, Adjustments, Type of output, Extras | Dave Birss, volgens hemzelf kort na de lancering van ChatGPT in november 2022 | Voorbeelden en bijsturing als eigen blok |
| RISEN | Role, Instructions, Steps, End goal, Narrowing | Toegeschreven aan Kyle Balmer; de oorspronkelijke bron konden we niet openen | De stappen, het einddoel en de afbakening |
De overheidsdienst van Singapore schrijft over CO-STAR: “At GovTech, our officers follow the CO-STAR Framework, featured in our Prompt Engineering Playbook, to craft better prompts.” Dave Birss beschrijft CREATE in zijn eigen samenvatting als een kader dat hij “Shortly after ChatGPT’s launch in November 2022” ontwikkelde.
In de praktijk liggen ze dicht bij elkaar. Wat CO-STAR onder Style, Tone en Audience zet, schrijf je in RACE in het Contextblok. Gebruik je RACE met een apart voorbeeldenblok, zoals hierboven, dan zit je inhoudelijk dicht bij CREATE.
Wat gaat er meestal mis met een RACE-prompt?
Zelden het kader zelf, bijna altijd de invulling. De klassiekers zijn een leeg Contextblok, meerdere taken in één prompt, een Execute-blok dat alleen “professioneel” zegt, een rol die als kennisbron wordt behandeld, en een sjabloon dat mechanisch wordt ingevuld zonder na te denken over de taak. Een stillere fout: Execute dat enkel opsomt wat er niet in mag.
Wat daartegen helpt, is banaal maar effectief. Behandel het eerste antwoord als een ruwe versie en stuur bij in een tweede beurt; een gesprek van 3 beurten levert meestal beter werk dan één megaprompt. Controleer feiten, cijfers en namen vóór publicatie, ook als het antwoord vlot geformuleerd is, want een taalmodel kan met overtuiging iets verzinnen (een hallucinatie). En bewaar wat werkt meteen, want de prompt die je vandaag na 4 pogingen goed krijgt, ben je volgende week kwijt.
Over de lengte hoef je je minder zorgen te maken dan vaak gedacht. Huidige modellen verwerken zeer lange instructies, dus relevantie weegt zwaarder dan beknoptheid. De grens ligt bij ruis: kopieer geen volledige documenten mee als alleen 3 regels ertoe doen. Wil je zien hoe de keuze tussen AI-tekst en eigen werk in de praktijk uitpakt, dan is AI-copywriting versus mens een nuttige aanvulling.
Hoe maak je van RACE een vaste werkwijze in je team?
Door het sjabloon te splitsen. Wat bij elke taak gelijk blijft, zoals rol, tone of voice en doelgroep, zet je één keer in vaste instructies. Wat per taak verandert, Action en het specifieke Execute-blok, blijft in de prompt. Bewaar daarnaast de beste ingevulde sjablonen centraal met invulvelden, zodat iedereen op hetzelfde niveau start.
In Claude kan dat met projecten. Anthropic omschrijft ze als “self-contained workspaces with their own chat histories and knowledge bases”, en per project kun je instructies vastleggen die de antwoorden sturen, bijvoorbeeld vanuit een specifieke rol. Werk je in een andere assistent, zoek dan de plek voor vaste instructies die bij elke chat meegaan. Wie verder wil, kan in Claude herbruikbare werkwijzen ook als skills vastleggen.
Praktisch: kies 3 terugkerende taken, werk er per taak één RACE-sjabloon voor uit, test een week, en scherp aan op basis van wat de output structureel mist. Spreek af wie de bibliotheek beheert en zet bij elk sjabloon één regel over wanneer je het gebruikt. Evalueer na een maand welke sjablonen echt gebruikt worden; die 2 of 3 zijn je winst, de rest mag weg. Groeit dat uit tot workflows die je liever automatisch laat lopen, dan is marketingautomatisering de volgende stap, en daarna AI-agents in marketing.
Wil je dat je team dit onder de knie krijgt op de eigen taken? ClickForest geeft praktijkgerichte AI-opleidingen aan KMO’s in Vlaanderen, waarin we samen de sjablonen en vaste instructies uitwerken voor het werk dat bij jullie elke week terugkomt. Bekijk de AI-opleiding of neem contact op.
Wat onthoud je over het RACE-model?
RACE is een geheugensteun met 4 blokken: Role, Action, Context, Execute. De E heeft varianten, Expectation en Examples, en geen officiële definitie, dus kies er één en blijf consequent. De waarde zit in de discipline die de blokken afdwingen, vooral in het Contextblok, en in voorbeelden die je als apart blok meegeeft. Een rol stuurt vooral toon en invalshoek.
Gebruik het kader waar het thuishoort: bij terugkerende taken die je wil standaardiseren. ClickForest helpt KMO’s in Vlaanderen om zulke sjablonen toe te passen op hun eigen terugkerende taken. Werk je liever met een lossere formule, begin dan bij prompts schrijven in 4 stappen; wil je verder dan sjablonen, ga dan naar prompt engineering. Welke assistent je kiest, maakt minder uit dan je denkt, al helpt onze vergelijking van AI-tools om te bepalen wat bij welke taak past. En wil je AI breder inzetten dan tekst alleen, dan begint dat bij AI voor groei.
Groeien met AI, concreet en zonder onnodige complexiteit
Klaar om AI in te zetten om tijd te besparen en je marketing te versnellen? Ontdek onze AI-diensten
Bespreek je uitdaging direct met Frederiek: Plan een gratis strategiegesprek of stuur ons een berichtje
Liever mailen? Stuur je vraag naar frederiek@clickforest.com of bel +32 473 84 66 27
Strategie zonder actie blijft theorie. Laten we je volgende stap samen zetten.
Veelgestelde vragen
RACE staat voor Role, Action, Context en Execute: je geeft de AI een rol, een concrete taak, de achtergrond van jouw situatie en een instructie over de vorm van het antwoord. In andere versies staat de E voor Expectation (het verwachte resultaat) of Examples (voorbeelden). Een officiële definitie bestaat niet; alle varianten vullen hetzelfde slotblok.
Nee. Het RACE-model van Smart Insights (Reach, Act, Convert, Engage) is een planningsmodel voor de klantreis in digitale marketing en zegt niets over prompts. Het RACE in dit artikel is een promptstructuur uit de AI-praktijk, met dezelfde 4 letters en geen enkel verband.
Inhoudelijk vrijwel niets: Role komt overeen met Rol, Action met Doel, Context met Context en Execute met Output. RACE is een strakker stramien met gelabelde blokken, handig voor herbruikbare sjablonen en teamafspraken. De formule uit de basisgids van ClickForest leest natuurlijker als je snel iets vraagt.
Nee. Voor een korte vraag volstaan Action en Context vaak. Het volledige sjabloon loont zodra de taak terugkeert, de output naar je merk moet klinken of meerdere collega's dezelfde kwaliteit moeten halen, en dan is Context het blok dat je het minst mag overslaan.
Ja. RACE is een manier om je instructie te ordenen en werkt in elke assistent die tekstprompts aanneemt. Anthropic raadt voor Claude aan om de blokken af te bakenen, bijvoorbeeld met XML-tags, en OpenAI noemt koppen en lijsten als hulpmiddel om delen van een prompt te scheiden.
Ja, met een kleine aanpassing. Volgens OpenAI werken redeneermodellen beter met instructies op hoofdlijnen, dus houd Action en Context scherp en laat Execute meer over het doel gaan dan over elk detail van de vorm. Trust Insights, de oudste gedateerde bron van RACE, zegt zelf dat het originele kader nog werkt.
Begin met 3 terugkerende taken, werk per taak één RACE-sjabloon uit en zet de vaste delen, zoals rol en tone of voice, in projectinstructies. Spreek af wie de bibliotheek beheert en evalueer na een maand welke sjablonen echt gebruikt worden. ClickForest werkt die sjablonen samen met je team uit tijdens een AI-opleiding op maat.
Bronnen en referenties
RACE als promptkader en de varianten van de E:
- Trust Insights: nieuwsbrief Inbox Insights van 12 juli 2023 (vroegste vermelding van RACE die we vonden) · https://www.trustinsights.ai/blog/2023/07/inbox-insights-ai-efficiencies-ripple-effects-chatgpt-code-interpreter/
- Trust Insights: nieuwsbrief Inbox Insights van 6 september 2023 (Role, Action, Context, Execute) · https://www.trustinsights.ai/blog/2023/09/inbox-insights-september-6-2023-when-chatgpt-goes-sideways-content-curation-systems/
- Trust Insights (Christopher Penn): Instant Insights over het RACE AI-framework (2024) · https://www.trustinsights.ai/insights/instant-insights/instant-insights-trust-insights-race-ai-framework/
- Trust Insights: podcast In-Ear Insights over het RAPPEL-framework (oktober 2024) · https://www.trustinsights.ai/blog/2024/10/in-ear-insights-the-trust-insights-rappel-ai-prompt-framework-explained/
- Trust Insights: nieuwsbrief Inbox Insights van 9 april 2025 (RACE voor redeneermodellen) · https://www.trustinsights.ai/blog/2025/04/inbox-insights-april-9-2025-ai-integration-strategy-part-1-ai-prompting-frameworks/
- Edi Hezri Hairi: "9 Frameworks to master ChatGPT Prompt Engineering" (variant met Expectation, 2023) · https://www.linkedin.com/pulse/9-frameworks-master-chatgpt-prompt-engineering-edi-hezri-hairi/
- Fabio Vivas: "RACE framework for prompts" (variant met Expectation, 2025) · https://fvivas.com/en/race-framework-prompts-llm/
- Side School: uitleg van RACE (variant met Examples, 2024) · https://www.side.school/en/resources/race
- Dr. Ayse Ozturk: "Another prompting framework: RACE" (2025) · https://drayseozturk.org/2025/02/22/another-prompting-framework-race-role-action-context-execute/
Andere promptkaders:
- GovTech Singapore: artikel over prompt engineering met het CO-STAR-framework (2025) · https://www.tech.gov.sg/technews/mastering-the-art-of-prompt-engineering-with-empower/
- Dave Birss: samenvatting Smarter learning with AI (het CREATE-framework, pdf) · https://davebirss.com/downloads/smarter_learning_with_AI_summary.pdf
Het andere RACE-model (marketingplanning):
- Smart Insights (Dave Chaffey): "The RACE Framework" (Reach, Act, Convert, Engage) · https://www.smartinsights.com/digital-marketing-strategy/race-a-practical-framework-to-improve-your-digital-marketing/
Officiële promptdocumentatie:
- Anthropic: "Prompting best practices" · https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/claude-prompting-best-practices
- OpenAI: Prompt engineering guide · https://developers.openai.com/api/docs/guides/prompt-engineering
- Google: "Prompt design strategies" (Gemini API) · https://ai.google.dev/gemini-api/docs/prompting-strategies
- Anthropic: Claude Help Center over projecten en projectinstructies · https://support.claude.com/en/articles/9517075-what-are-projects
Onderzoek naar rollen in prompts:
- Zheng et al.: "When A Helpful Assistant Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models" (2023, herzien 2024) · https://arxiv.org/abs/2311.10054
- Wharton Generative AI Labs: "Playing Pretend: Expert Personas Don't Improve Factual Accuracy" (2025) · https://gail.wharton.upenn.edu/research-and-insights/playing-pretend-expert-personas/
- Knowledge at Wharton: interview met Lennart Meincke over expertrollen in prompts (april 2026) · https://knowledge.wharton.upenn.edu/article/why-you-shouldnt-ask-chatbots-to-act-like-an-expert/