Veesie: meten of AI je merk noemt, elke week, met de ruis eruit
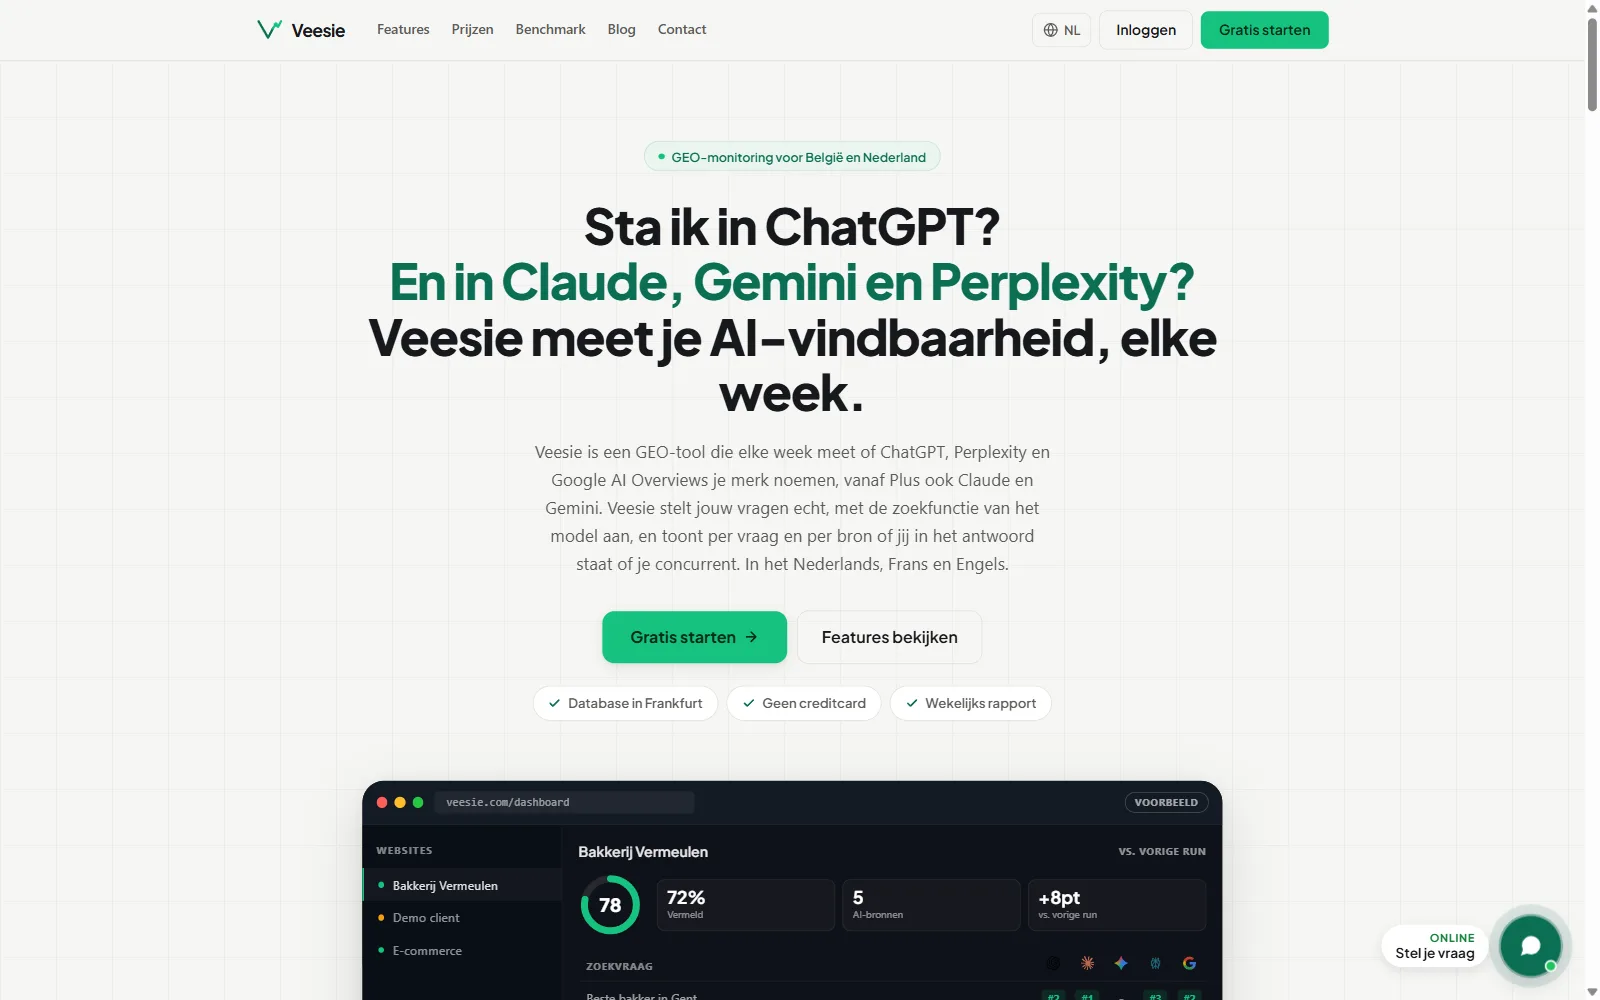
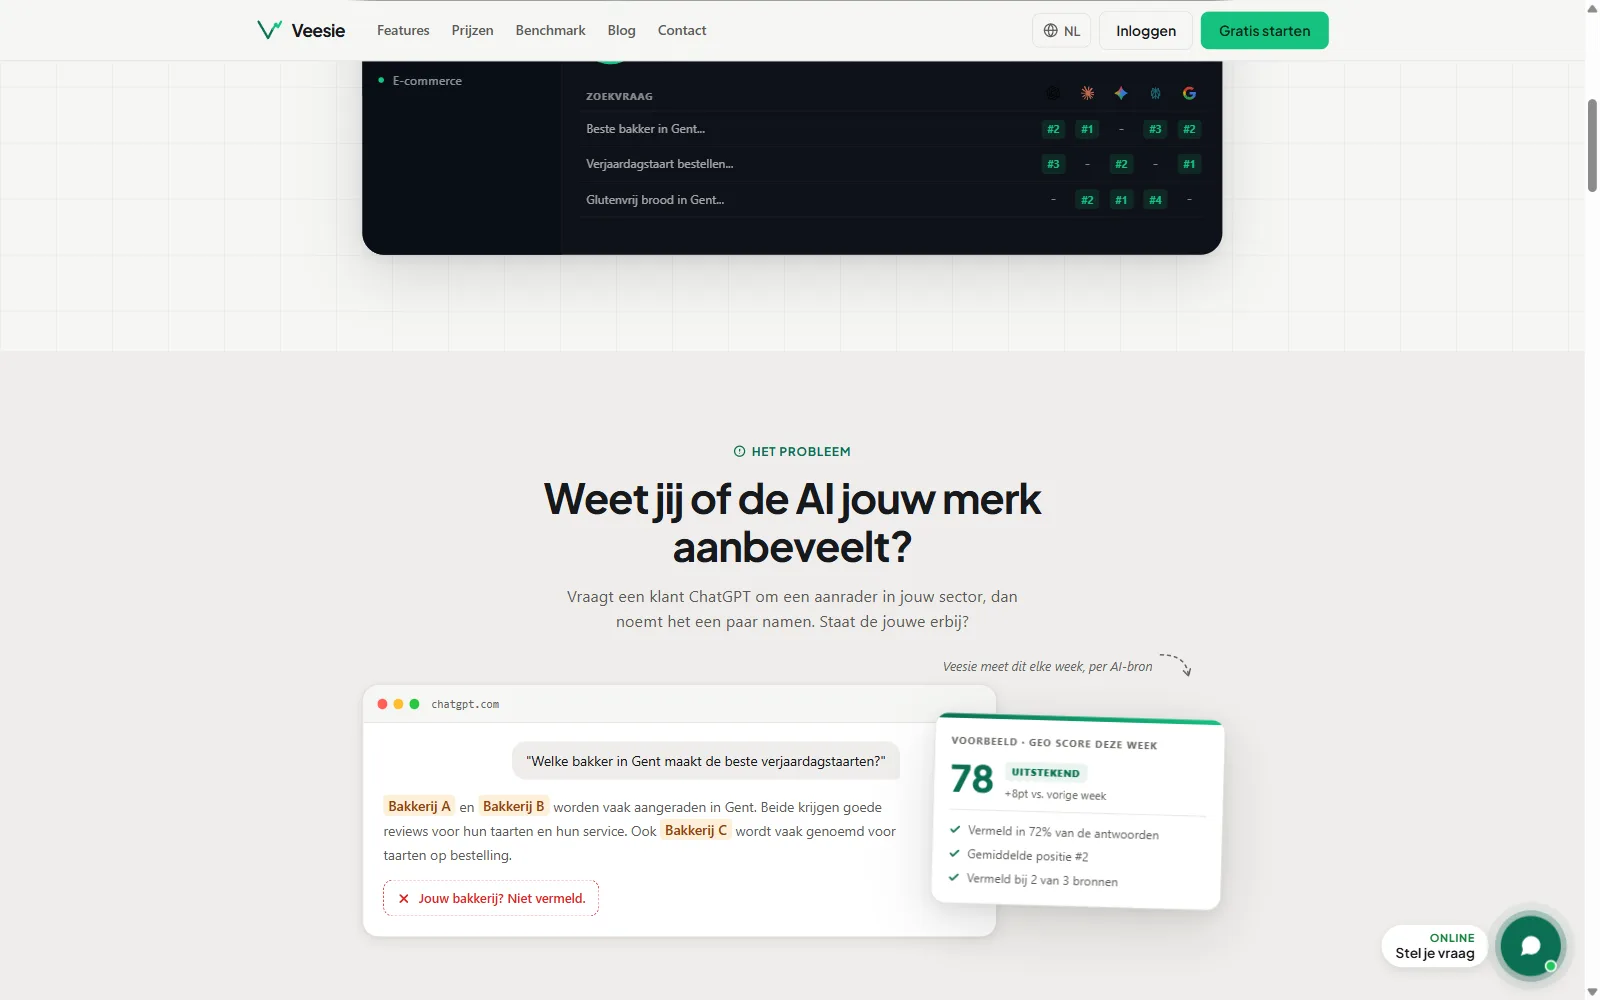
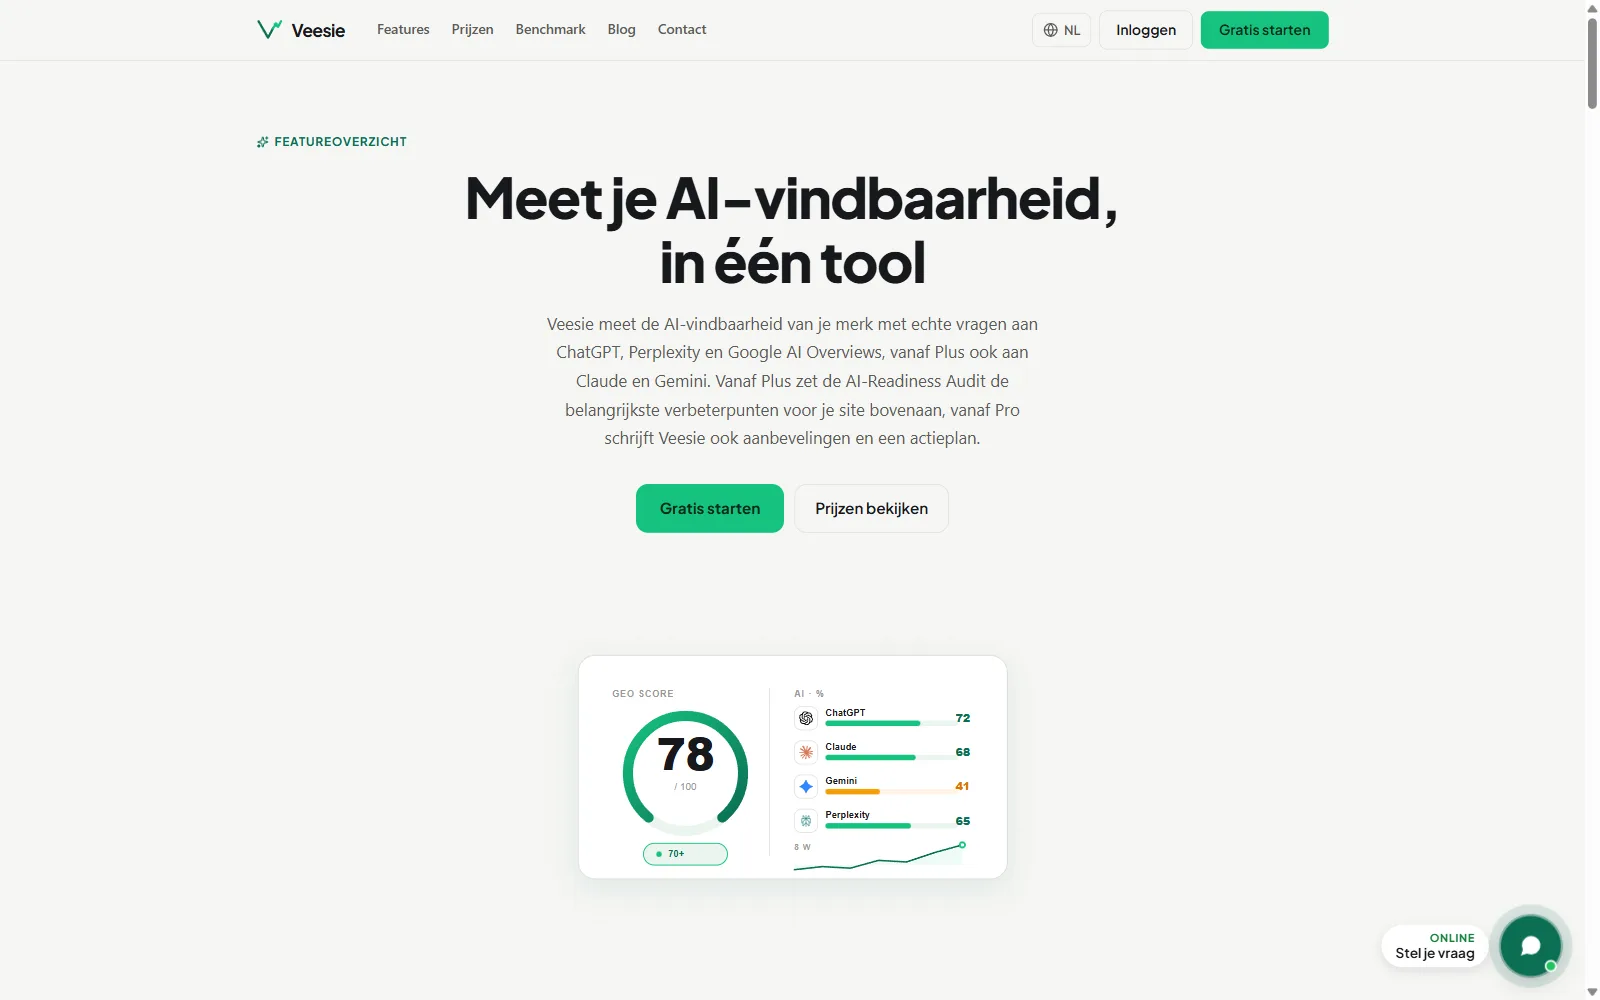
Veesie is een eigen SaaS-merk dat we van nul bouwden. Het stelt de vragen die je klanten stellen aan ChatGPT, Claude, Gemini, Perplexity en Google AI Overviews, met de zoekfunctie van het model aan, en telt wie er in het antwoord staat. Elke week, in het Nederlands, Frans en Engels, en zo opgezet dat één toevallig antwoord je cijfer niet bepaalt.
Vraag een AI-assistent twee keer hetzelfde en je krijgt twee antwoorden. Wie dat meet zonder herhaling, meet het toeval.
Uitdaging
Steeds meer klanten vragen een AI-assistent om een aanrader in plaats van tien blauwe links te doorzoeken. Een bedrijf wil dus weten of het in die antwoorden staat, naast wie, en of dat beter wordt. Alleen: een AI-antwoord verschilt per keer, per model en per taal, en een momentopname is dan weinig waard. De vraag was of je daar een cijfer van kan maken dat iets betekent, en dat elke week opnieuw.
Aanpak
Echte vragen, live gesteld met de zoekfunctie van het model aan, op vijf bronnen. Herhaling waar de modellen het meest wisselen, een vaste korf van drie bronnen voor de score zodat je lijn niet verspringt, en alles wat geen oordeel vraagt in code. Gebouwd met Claude Code, en bewaakt door een testset die meegroeide met elke functie: 521 testbestanden op het moment van deze case.
5
AI-bronnen per vraag: ChatGPT, Claude, Gemini, Perplexity en Google AI Overviews
4 punten
verschil tussen de hoogste en de laagste van vijf identieke metingen op één dag (25 augustus 2026, 12 vragen): 85, 87, 84, 88 en 85
0
gemiste vermeldingen bij de uitlezing van 655 antwoorden (toets 24/08/2026)
521
testbestanden in de repo, met de prijzen, plangrenzen en chatbotkennis als bewaakte feiten
Echte vragen, met de zoekfunctie aan
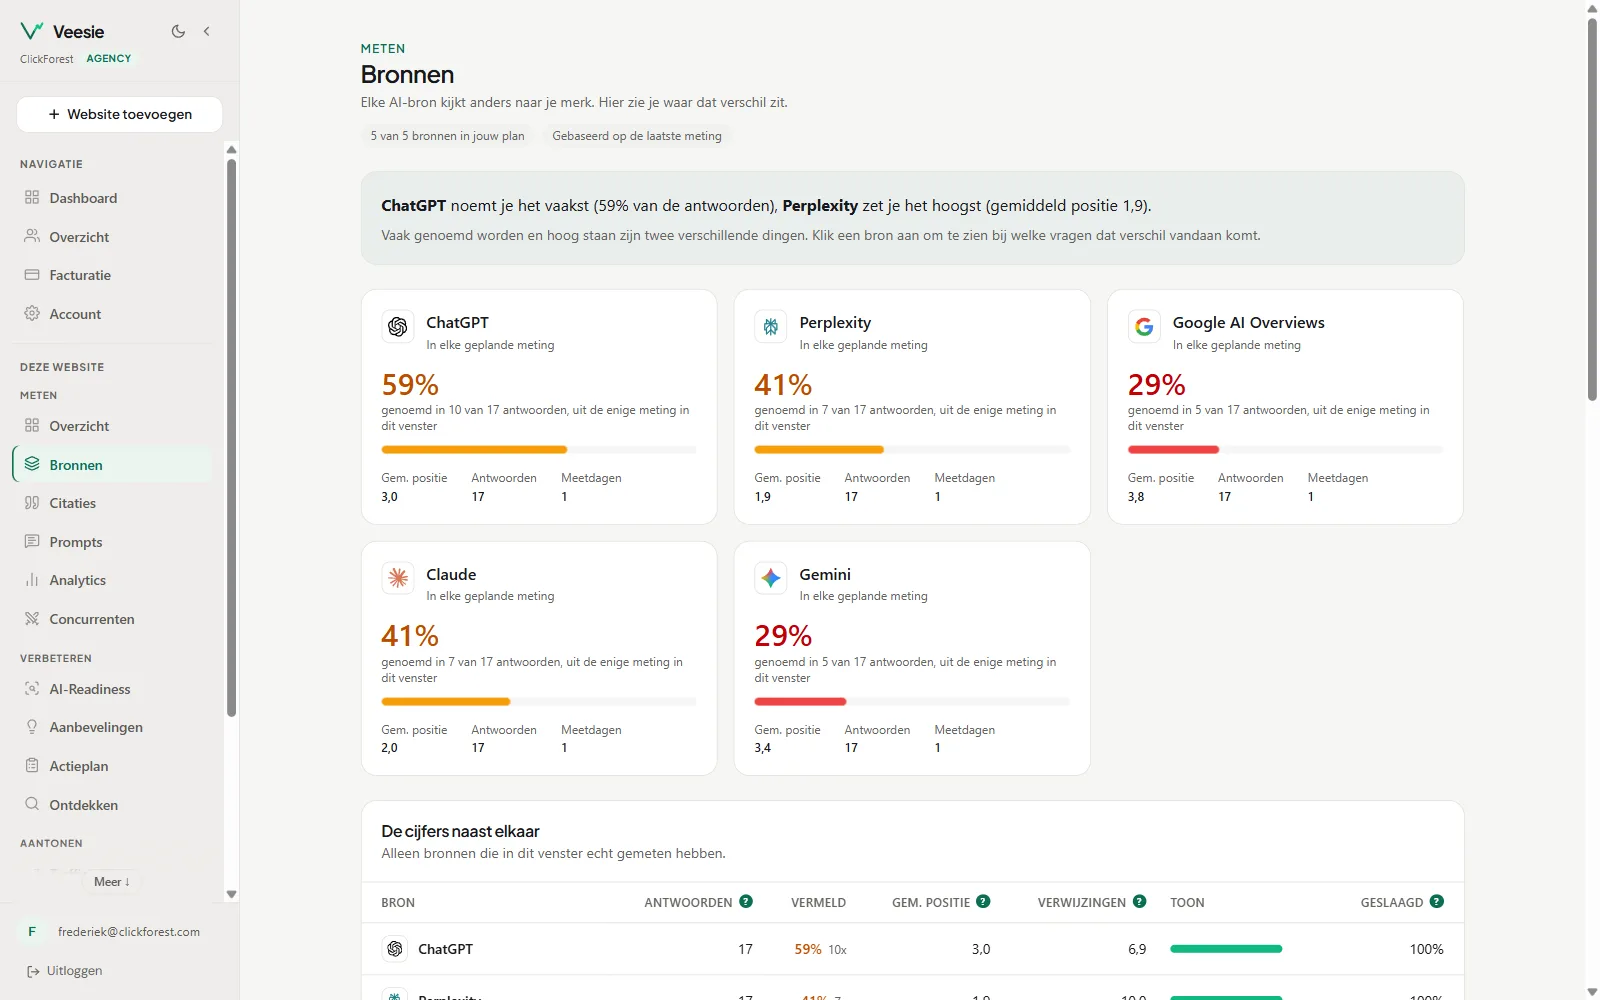
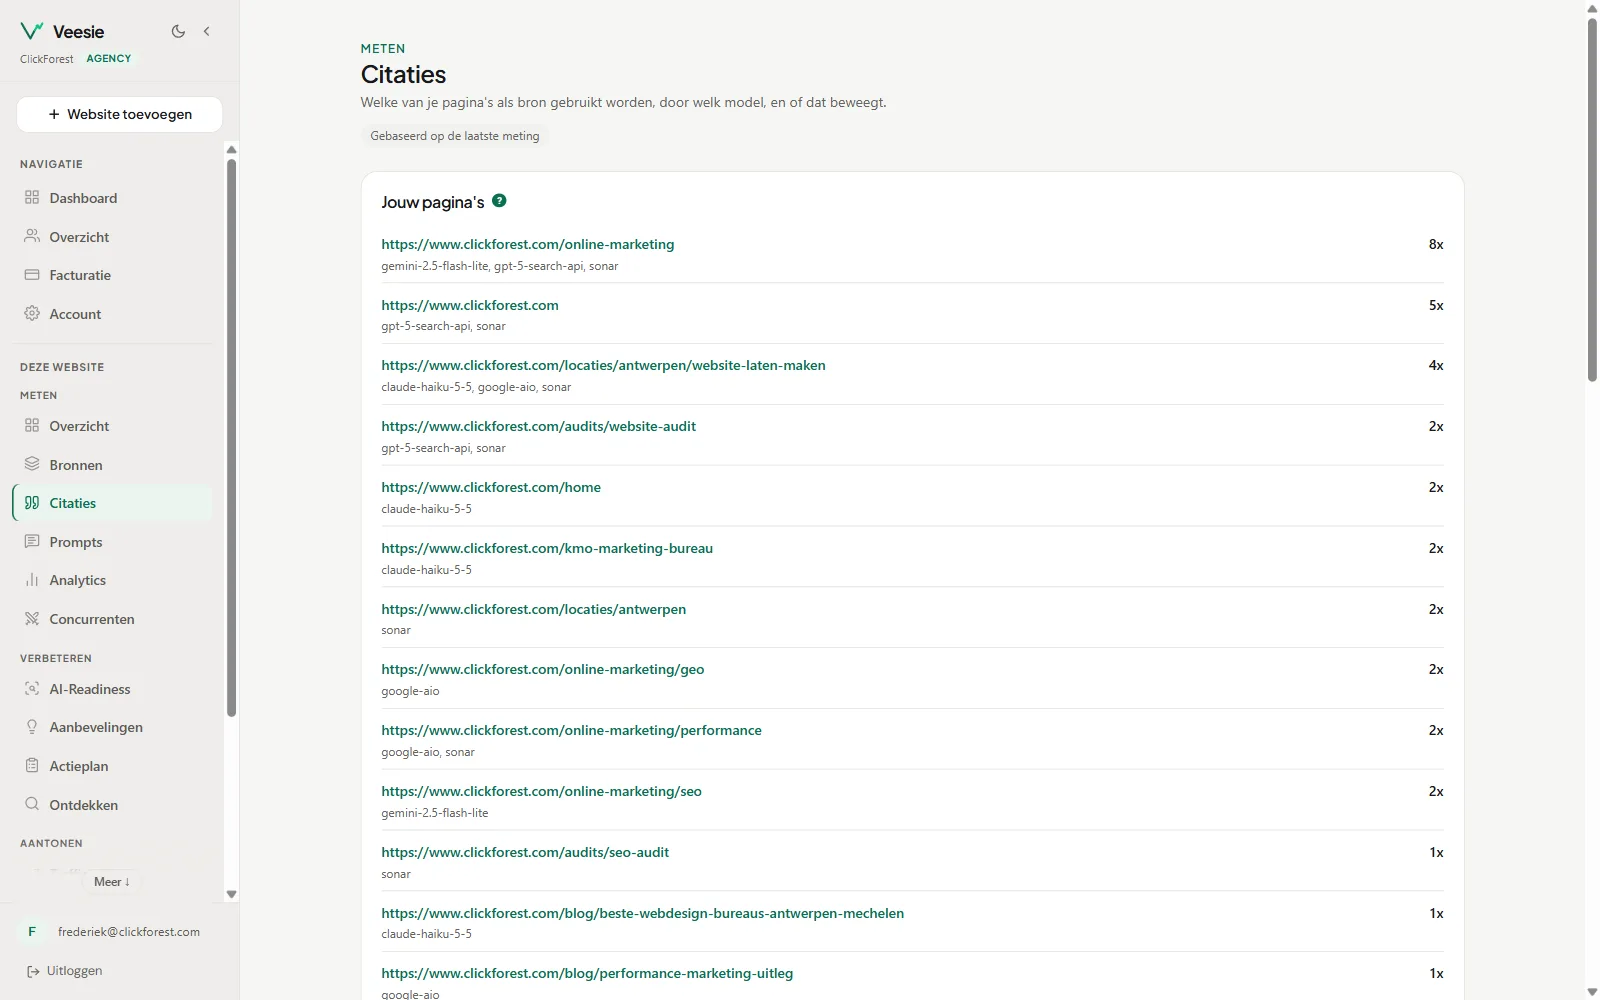
Elke vraag gaat live naar de bron, met de zoekfunctie aan: gpt-5-search-api voor ChatGPT, sonar voor Perplexity, Claude Haiku 5.5 en Gemini 2.5 Flash-Lite met web search, en Google AI Overviews rechtstreeks uit de echte Google-resultaten via DataForSEO. Haalt het model bronnen aan, dan bewaart Veesie die bij het antwoord, met een klikbare link. Zo zie je niet alleen óf je genoemd wordt, maar ook welke pagina's de AI daarvoor las.
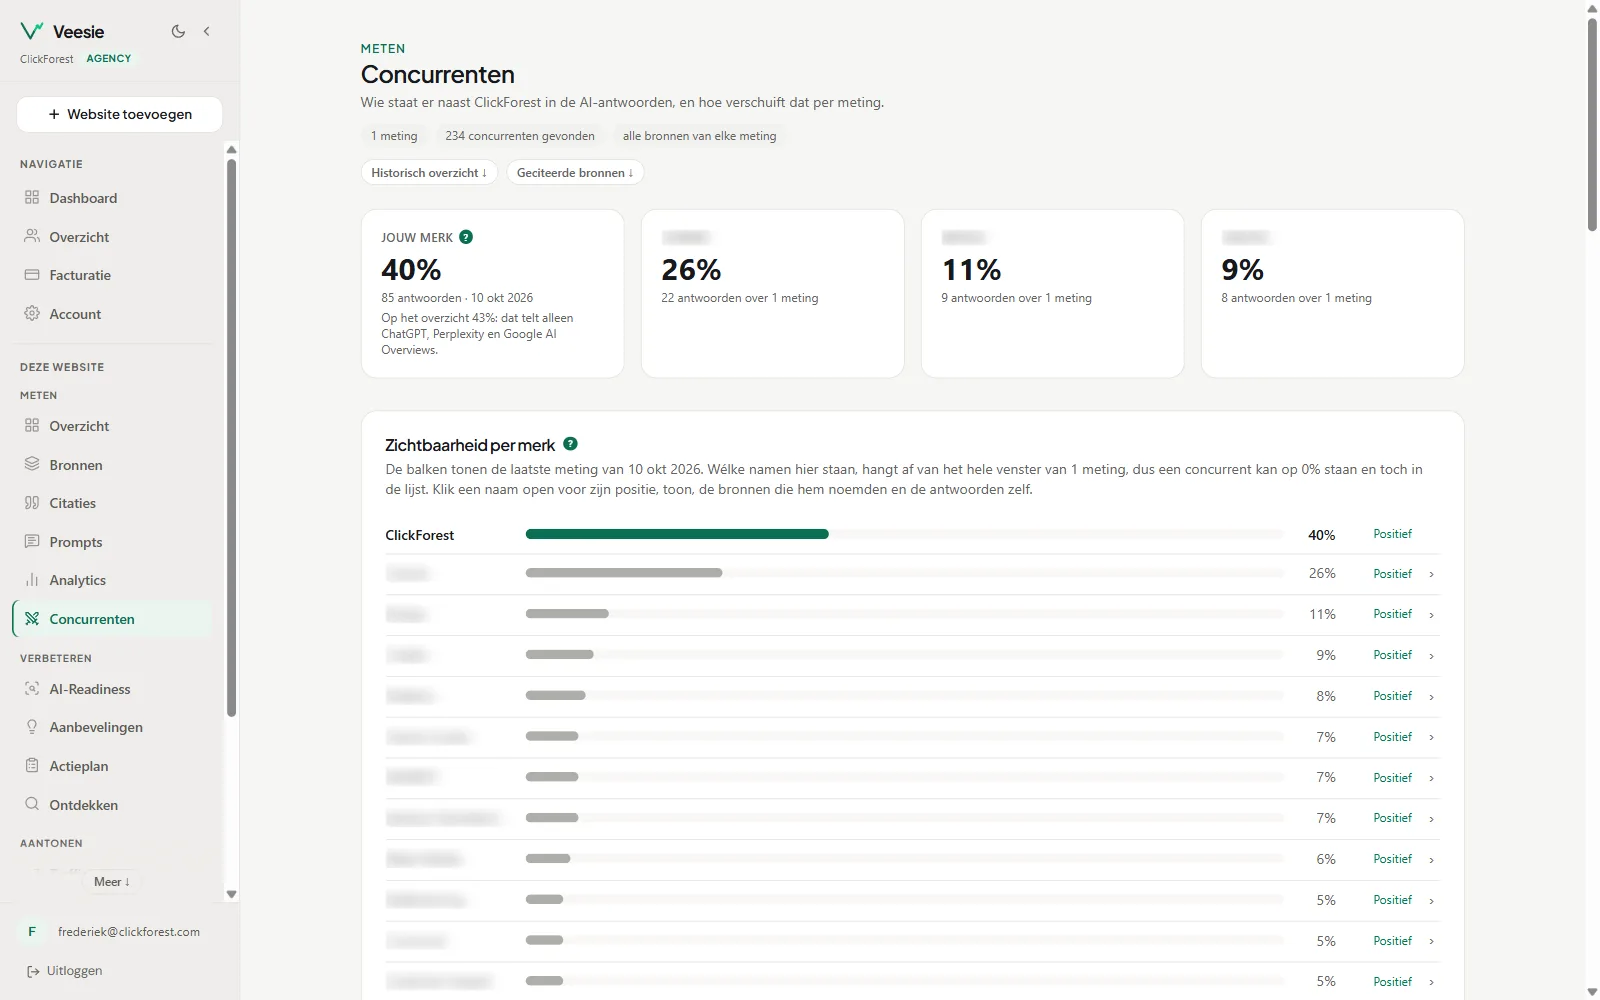
Per antwoord registreert Veesie of het merk vermeld wordt, op welke positie, in welke context en met welk sentiment. De extractie is getoetst op 655 antwoorden over zeven dagen: nul gemiste vermeldingen die letterlijk in de tekst stonden, nul vermeldingen zonder grond.
Eén meting is ruis, vijf metingen tonen het patroon
Op 25 augustus 2026 liet Veesie vijf identieke metingen lopen op clickforest.com: 12 vragen, vijf bronnen, binnen een uur, met de modellen van toen (Claude Haiku 4.5; sinds 8 oktober 2026 meet Veesie met Haiku 5.5). De score bleef stabiel: 85, 87, 84, 88 en 85. Daaronder wisselde wel van alles. Bij 14 van de 60 combinaties van vraag en bron viel het antwoord de ene keer anders uit dan de andere, en 10 van die 14 kwamen van Claude en Gemini.
Vijf identieke metingen op clickforest.com, 25 augustus 2026, 12 vragen.
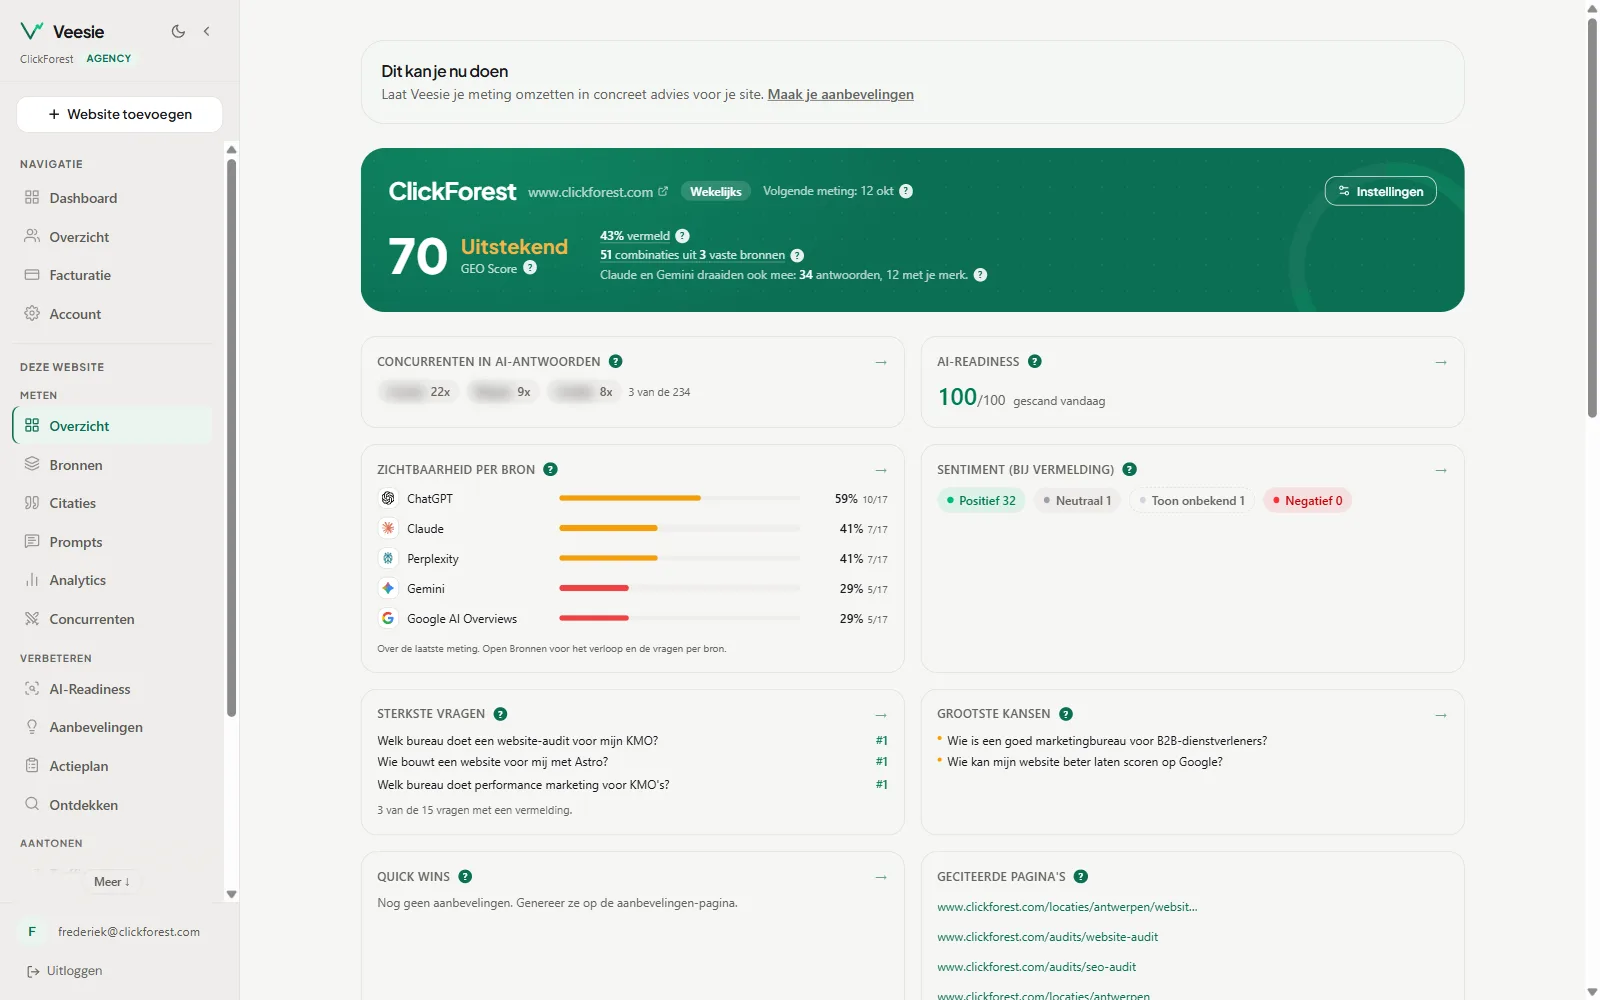
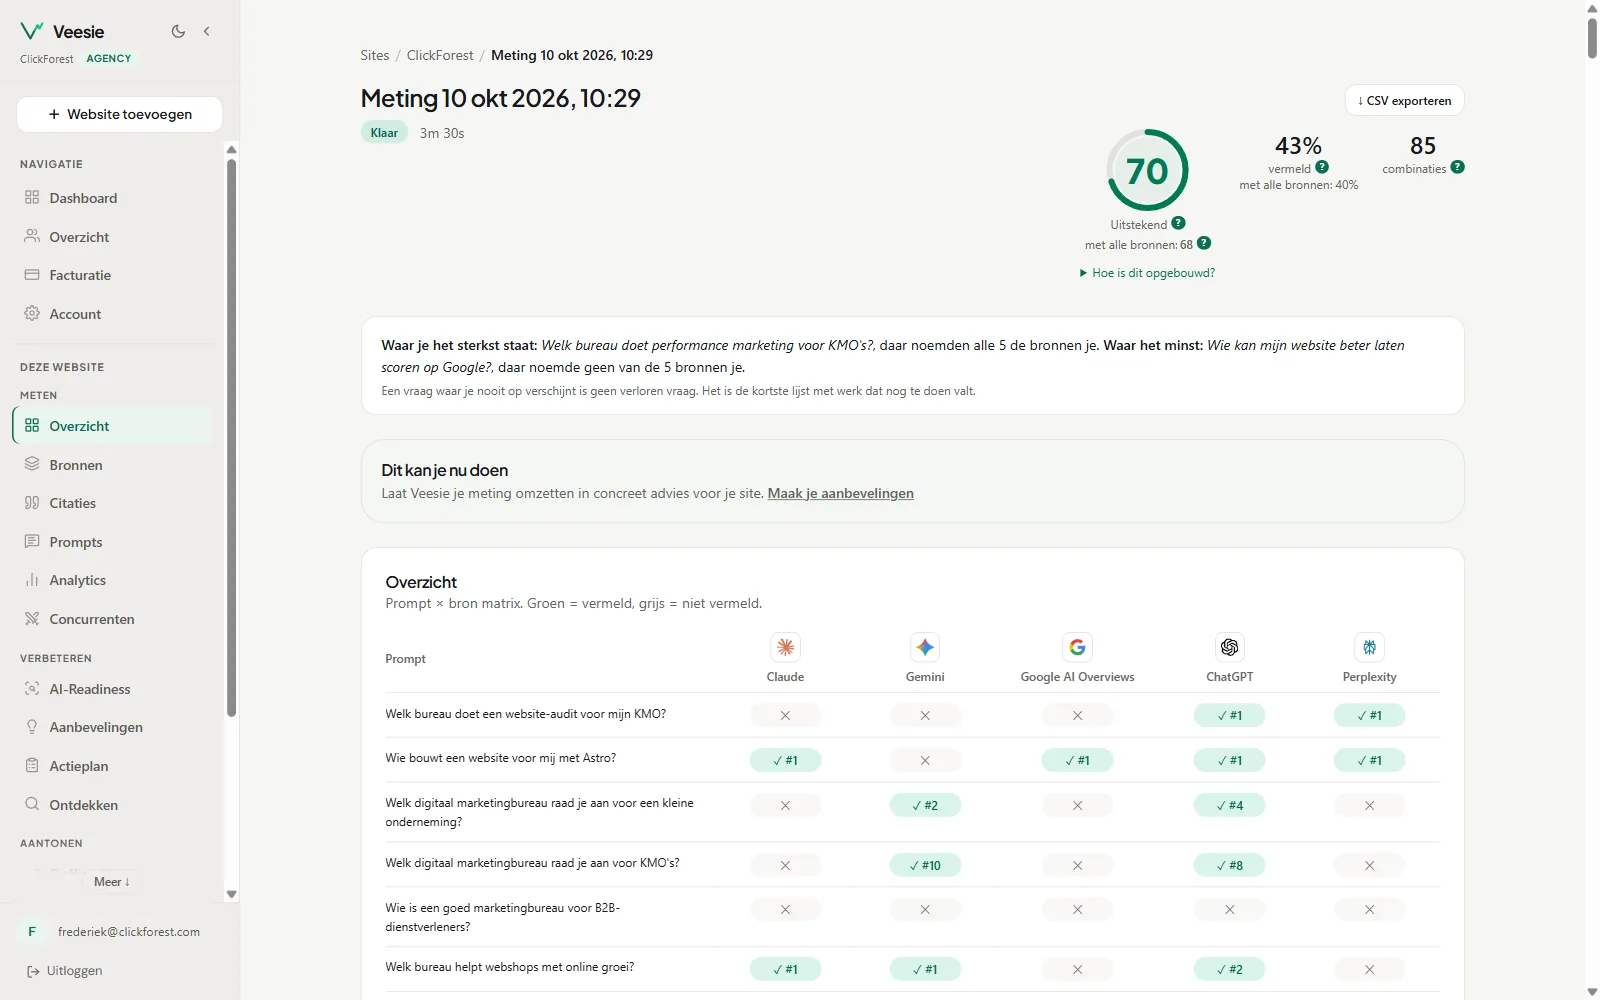
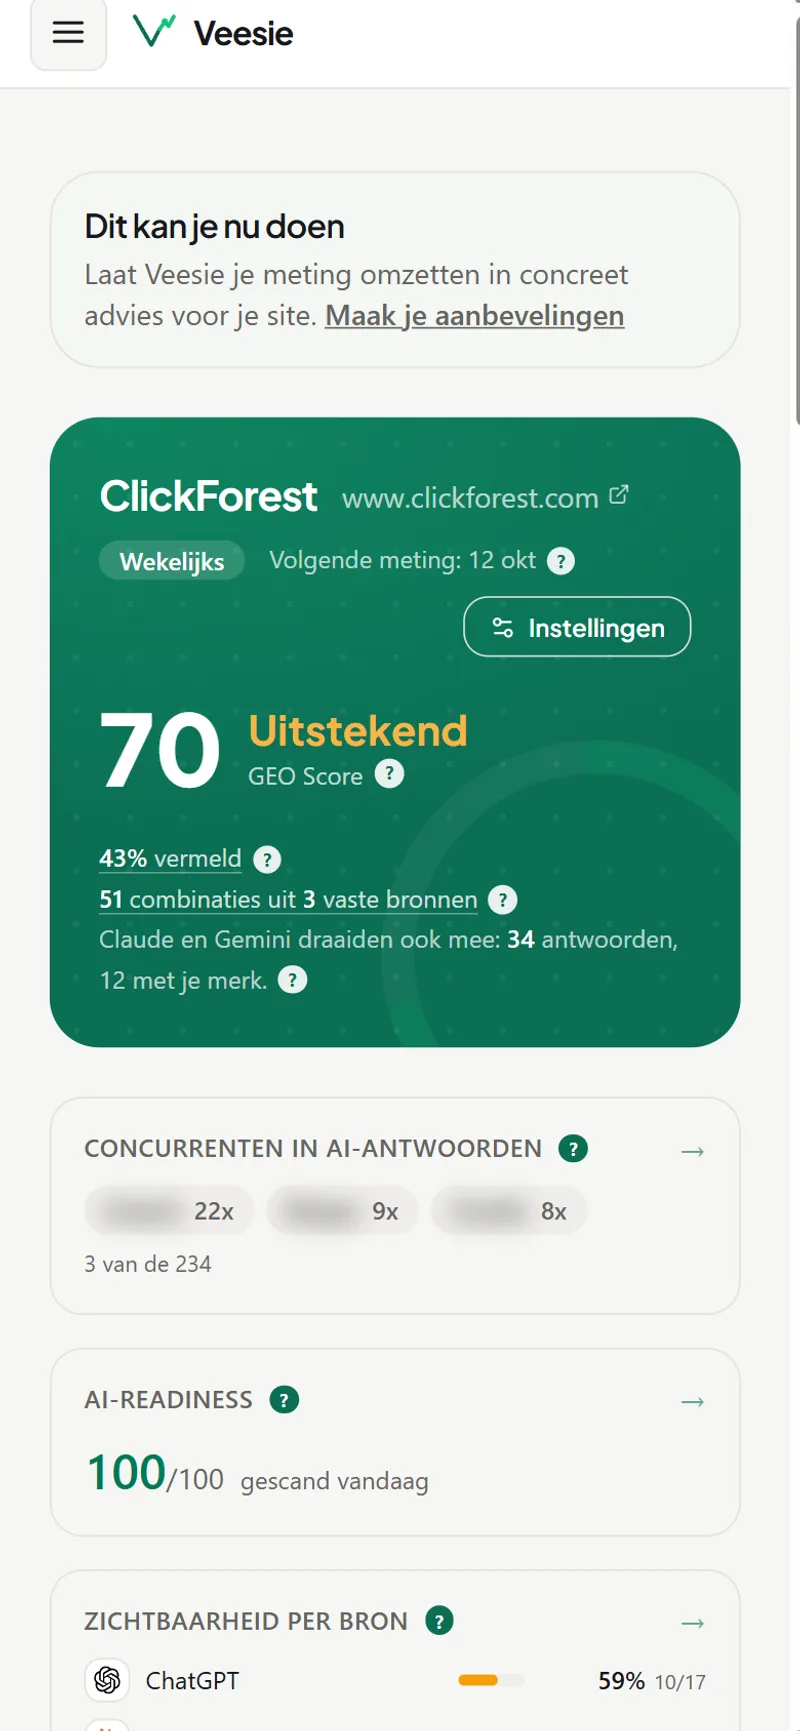
Die test gaat over hoe stabiel het cijfer is bij dezelfde vragen, niet over het niveau. Het dashboard in de galerij toont een nieuwe meting van 10 oktober 2026 op 17 andere vragen, die Veesie uit de site afleidde, en daar staat clickforest.com op 70. Een andere vragenset geeft een ander niveau.
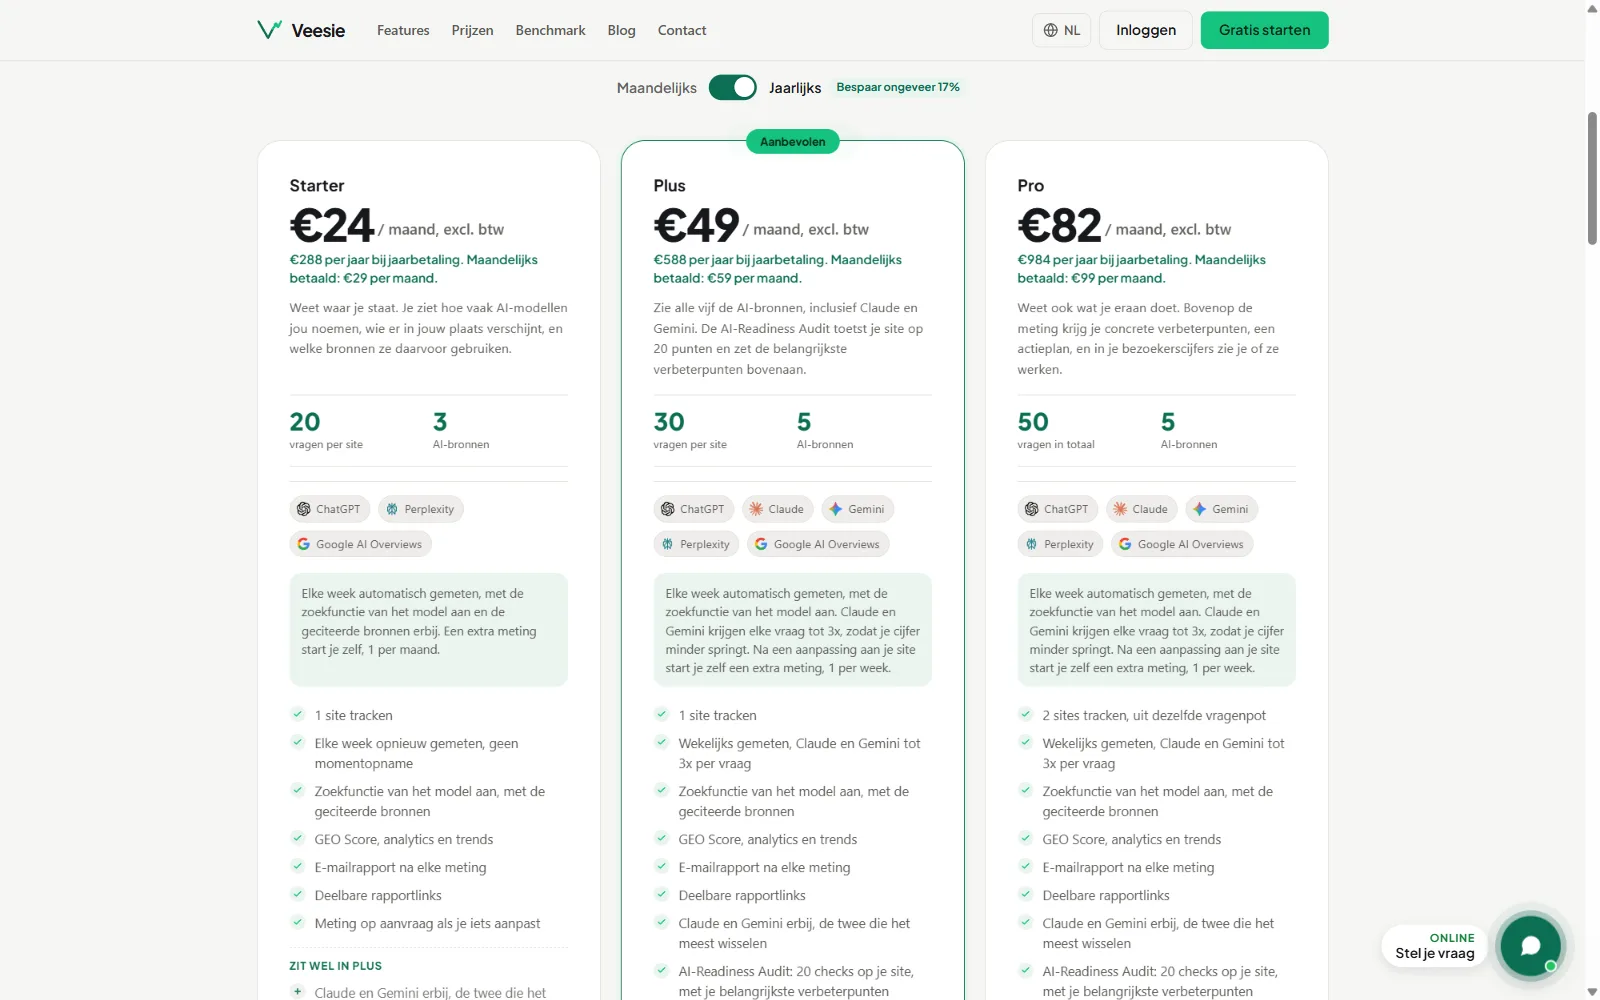
Daaruit volgden twee ontwerpkeuzes. Claude en Gemini krijgen elke vraag tot drie keer, en Veesie bewaart de meerderheid. En wekelijks werd het maximum op elk plan: vaker meten verandert het cijfer nauwelijks, wat wel verandert is je site. Daarvoor is er een extra meting op aanvraag, na een aanpassing.
Een score die niet verspringt
De GEO Score is een eigen index van 0 tot 100, en daarom staat de formule publiek (veesie.com/features): 50% vermeldingsrate, 25% sentiment, 15% bronnendekking en 10% positie in het antwoord. De score rekent op elk plan over dezelfde drie bronnen: ChatGPT, Perplexity en Google AI Overviews. Claude en Gemini worden vanaf Plus gemeten en getoond, maar tellen niet mee. Wie van plan wisselt, ziet zijn lijn dus niet springen door een andere korf.
50251510
Vermeldingsrate 50%
Sentiment 25%
Bronnendekking 15%
Positie 10%
Van meting naar advies
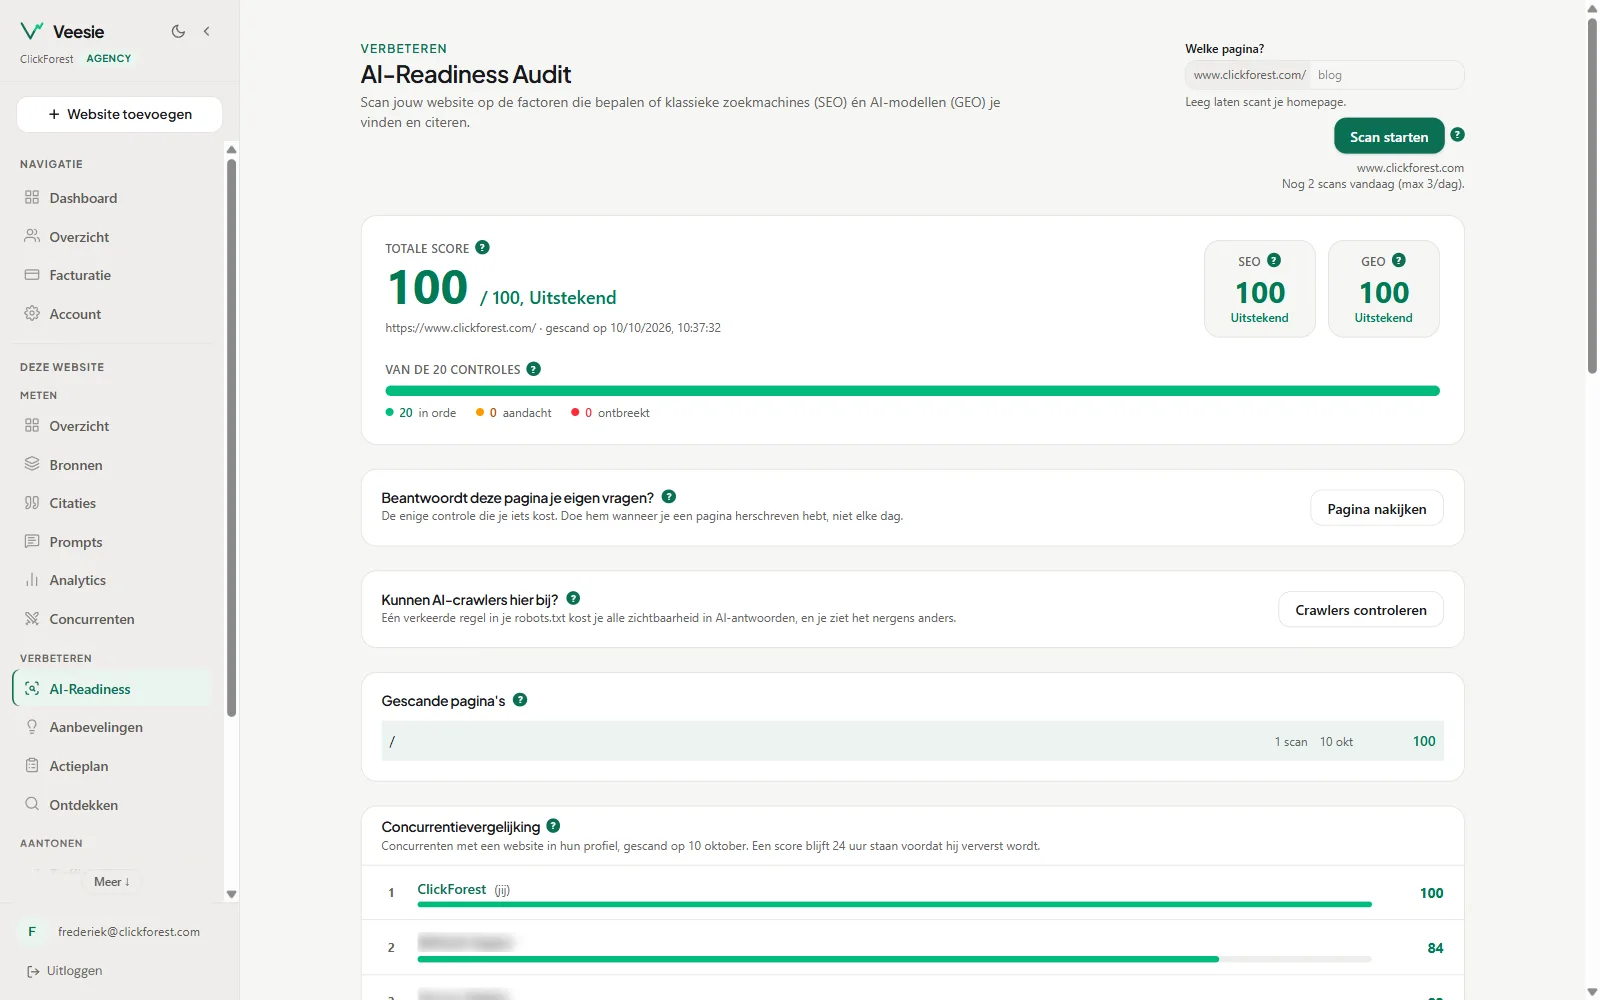
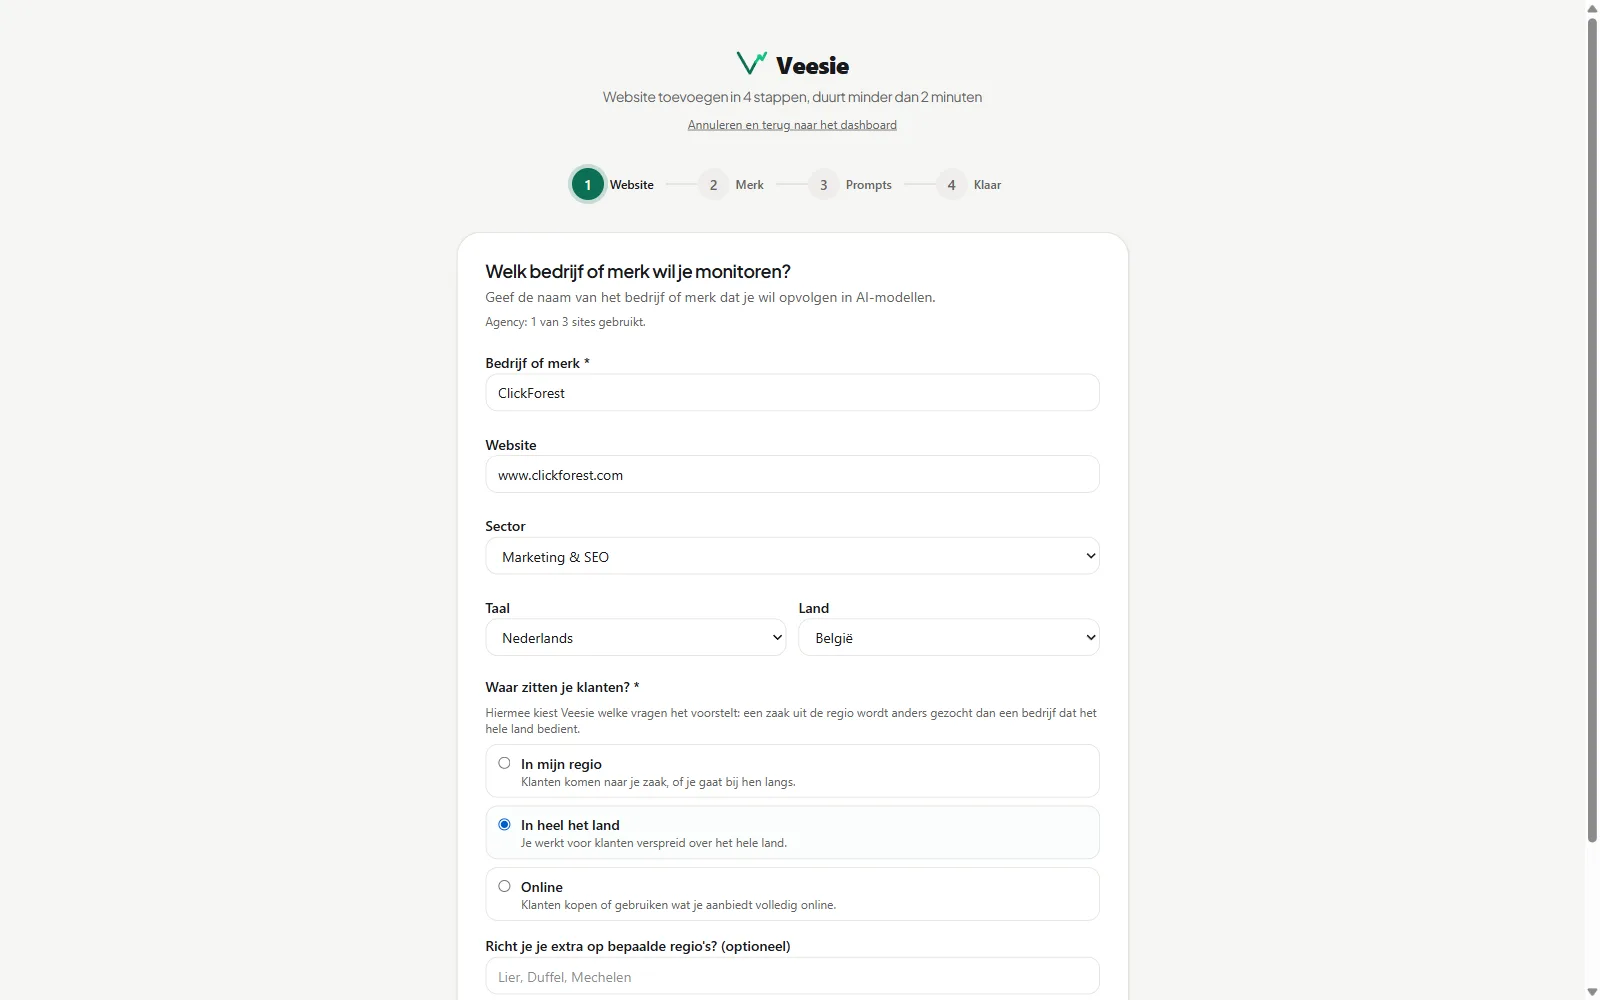
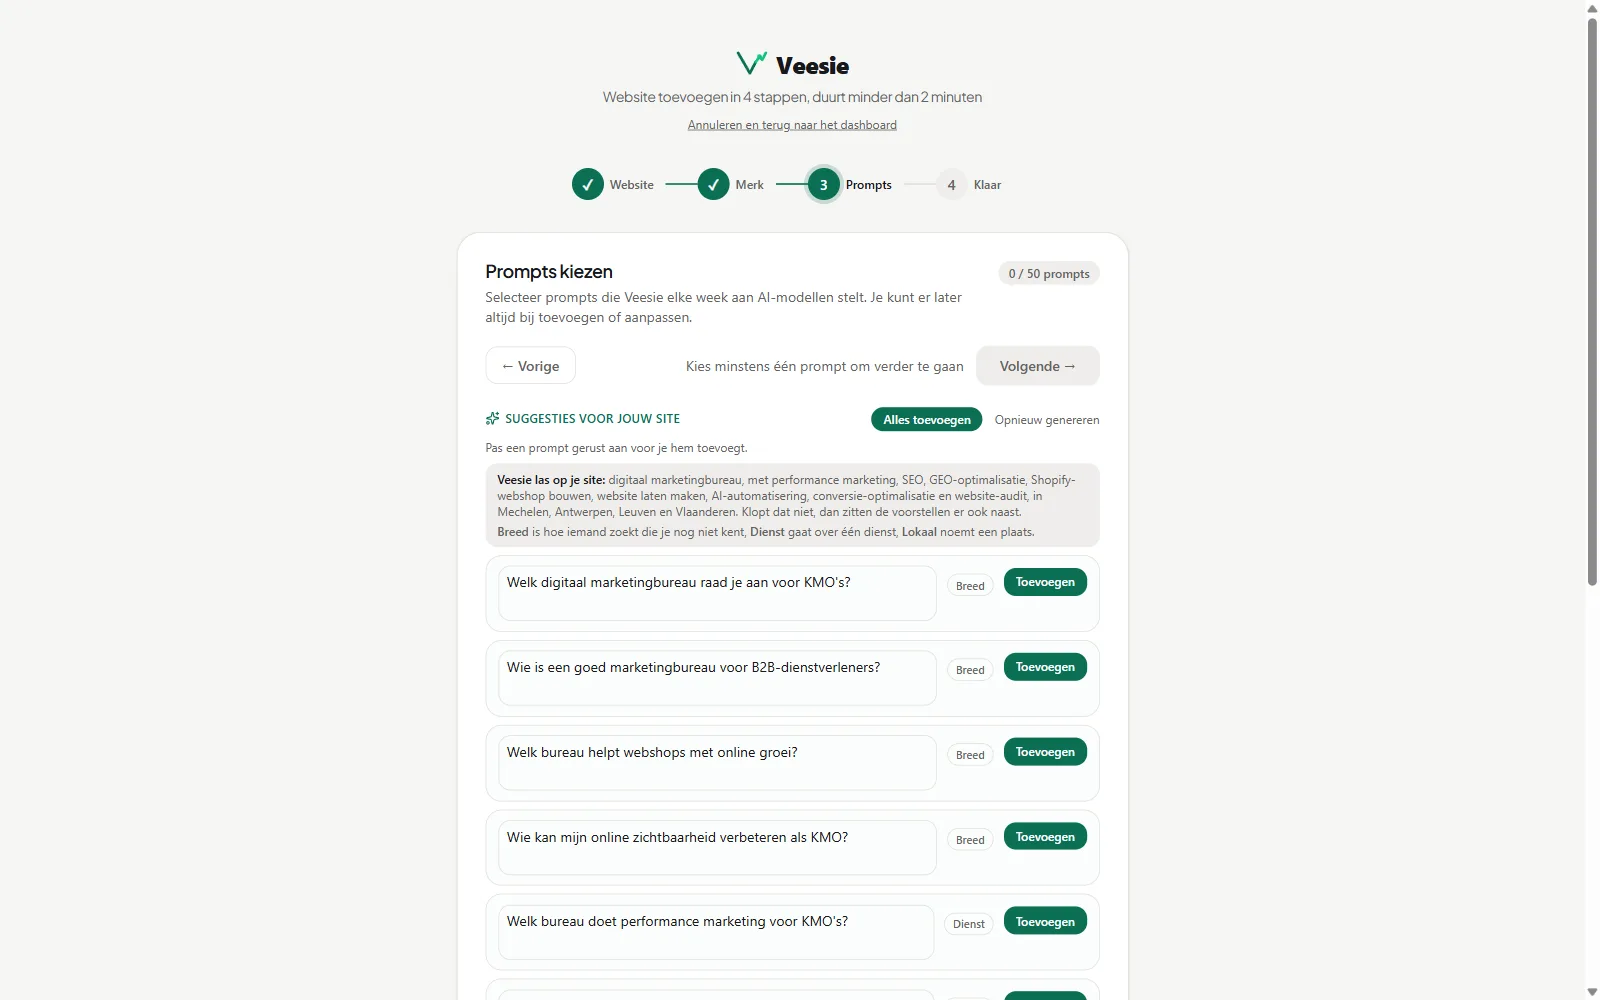
Meten is de helft. Bij het toevoegen van een website leest Veesie de site zelf en stelt het vragen voor in drie soorten: breed, per dienst en lokaal. Vanaf Plus toetst de AI-Readiness Audit de site op 20 controles, tien voor SEO en tien voor GEO, en zet ze de belangrijkste verbeterpunten bovenaan. Vanaf Pro schrijft Veesie GEO Aanbevelingen op basis van de laatste vijf metingen, zet ze in een actieplan, en laat de GA4-koppeling in je eigen bezoekerscijfers zien hoeveel verkeer AI oplevert. Die koppeling leest Google Analytics met de scope analytics.readonly, door Google geverifieerd op 24 augustus 2026.
Veesie is gebouwd met Claude Code, van de eerste commit op 25 april 2026 tot de publieke lancering in oktober: 1.927 commits en 100 databasemigraties. Wat het betrouwbaar maakt, is de testset eronder. Naast de meetlogica toetst ze ook de feiten die bezoekers lezen. Prijzen en plangrenzen komen uit één configuratiebestand, en tests falen als een tekst of de chatbot een functie belooft die het plan niet heeft, of een aantal noemt dat niet meer klopt. Een chatbot die een functie niet kent, zegt niet "dat weet ik niet". Hij antwoordt even stellig uit wat hij wél heeft. Dus wordt ook zijn kennis getest.
Een GEO-tool moet zelf correct geciteerd worden
Een tool die AI-vindbaarheid meet, wordt zelf ook door AI beschreven. Op 9 oktober 2026 toonde een AI-assistent Veesie in een vergelijking met het verkeerde logo en citeerde hij de jaarprijs als maandprijs. De oorzaak zat waarschijnlijk in de eigen site: een schema-markering die twee merken als één entiteit beschreef, en een prijzenpagina die de jaarprijs groot toonde zonder dat erbij te zeggen. Dezelfde dag stonden er citeerbare zinnen per plan, FAQ's op precies die misverstanden, een gecorrigeerd schema en een IndexNow-ping voor alle 69 pagina's. Tests bewaken dat het niet terugkomt.
Wat het kost om te draaien
Veesie draait per familie het goedkoopste model, met de zoekfunctie aan. Bij web search bepaalt de zoeklaag het antwoord meer dan de grootte van het model, en dat maakt een wekelijkse meting mogelijk vanaf €29 per maand. De kost per meting wordt niet geschat maar berekend uit echte metingen en de tarieven per model, en bij elke modelwissel opnieuw nagekeken. De metingen zelf lopen via Inngest, met een eigen stap per combinatie van vraag en bron, zodat een meting van 85 combinaties niet tegen de tijdslimiet van één Worker aanloopt.
Wat we niet claimen
Geen klantresultaten. Veesie staat sinds oktober 2026 publiek open. Cijfers over wat klanten ermee bereikten, komen er pas als die er zijn.
Geen spiegel van de consumentenapp. Veesie draait het goedkoopste model per familie, met de zoekfunctie aan. Welk merk een model eerst noemt, kan verschillen van wat iemand vandaag in de app ziet. Als relatieve maat, week na week, is de meting wel betrouwbaar.
Eén stabiliteitstest, op één site. De reeks 85, 87, 84, 88 en 85 komt van clickforest.com, een merk dat vaak genoemd wordt. Bij een merk dat bijna nergens staat, springt het cijfer relatief meer: op veesie.com zelf ging dezelfde soort meting van 0 naar 22.
Geen industriestandaard. De GEO Score is een eigen index. Daarom staat de formule op de site, zodat je weet wat een stijging betekent.
Veesie zelf wordt nog nauwelijks genoemd. Een nieuw merk moet die zichtbaarheid nog opbouwen, en Veesie meet dat bij zichzelf ook, elke week.
Vijf bronnen, elke week
ChatGPT, Claude, Gemini, Perplexity en Google AI Overviews, live bevraagd met de zoekfunctie aan, in het Nederlands, Frans en Engels.
Herhaling tegen de ruis
Claude en Gemini krijgen elke vraag tot drie keer. Vijf identieke metingen op één dag gaven 85, 87, 84, 88 en 85.
Feiten die getest worden
Prijzen, plangrenzen en wat de chatbot vertelt, komen uit één bron en worden door de testset bewaakt.
Gebruikte tools
Claude Code (bouwen met AI)
Next.js 15 en React 19, via OpenNext op Cloudflare Workers
Supabase (Postgres en Auth) in Frankfurt
Inngest voor de metingen, met een stap per vraag en bron
OpenAI, Anthropic, Google, Perplexity en DataForSEO als AI-bronnen
Een echte aanradar! Frederiek heeft een uitgebreide expertise en werkt uiterst professioneel. Hij is echt geëngageerd om ons als klant te helpen het beste uit onze website en digitale marketing te halen. Hij doet de moeite om ons als bedrijf te leren kennen en dit te vertalen naar onze digitale zichtbaarheid en zo impact te hebben voor ons. Zeer duidelijke communicatie en aangename samenwerking.
Super fijne ervaring met ClickForest, vanaf het begin een duidelijke uitleg over de gang van zaken & de toekomst van het digitale landschap. Duidelijk expertise aanwezig & heel direct en persoonlijk contact. Communicatie verliep heel vlot en de transparante offerte vormde de basis van de samenwerking. Tijdens het traject merkten we hoe snel Frederiek kan schakelen. Elke e-mail en vraag wordt binnen de kortste keren opgevolgd, oftewel per WhatsApp, telefoon of mail. Dag na dag zagen we veranderingen gebeuren aan onze shop in de goede richting. Feedback werd super snel opgevolgd en gedeeld met ons. Geen weken wachten op een antwoord, maar persoonlijk contact 1 op 1, telkens met dezelfde persoon. Zo hoort het!
Een blijvende, tevreden klant hier!
Na bevraging van verschillende website-bouwers was onze keuze gevallen op "ClickForest", die niet de goedkoopste was, maar een vrij directe en persoonlijke aanpak voorstelde. Dankzij een goede samenwerking met Frederiek was de lancering van onze nieuwe website "Servaes Services" op een snelle en efficiënte manier een feit en raden wij hen dan ook ten zeerste aan.
Uitstekende service en een prachtig eindresultaat. Mijn website werd professioneel opgebouwd, met veel aandacht voor detail en gebruiksvriendelijkheid. Vlotte communicatie, snelle uitvoering en een zeer aangename samenwerking. Zeker een aanrader!!!
Vanaf het eerste gesprek voelde ik meteen een klik met Frederiek. De passie en toewijding die hij in zijn werk en projecten legt, heeft mij zelfs meer dan eens weten te ontroeren. Hij heeft tonnen ervaring en kennis en dat straalt hij ook uit! Daarnaast staat hij ook open voor dialoog en speelt hij altijd en overal kort op de bal, waardoor elke kleine stap ineens als een grote sprong voorwaarts voelt. Wat mij nog het meest kan bekoren, is zijn visie op lange termijn. Vanaf het begin van de samenwerking voel je dat hij niet uit is op gewoon werk afleveren en factuur sturen. Hij denkt samen met mij mee naar waar ik met mijn project wil staan binnen een jaar, 3 jaar, 5 jaar en verder. Bedankt voor al je prachtige werk tot dusver Frederiek en hopelijk mogen we nog vele jaren succesvol samenwerken!
Vijf jaar geleden zette ik alles op alles en deed ik een stevige investering. Het restaurant was verleden tijd, en de nieuwe webshop gebouwd door Clickforest werd onze toekomst. Wat begon als een noodoplossing, groeide uit tot een prachtige, goed draaiende Shopify-shop én een samenwerking met een vaste, betrouwbare partner waar ik blind op kan vertrouwen. Achteraf bleek dat een schot in de roos. Toen door corona alle restaurants de deuren moesten sluiten, wist ik meteen: dit gaat langer duren dan drie weken. Ik wilde niet bij de pakken blijven zitten en besloot vooruit te kijken. Als kok en restauranthouder had ik nul ervaring met online marketing of SEO dat was voor mij compleet nieuw. Maar dankzij Frederiek van Clickforest leerde ik stap voor stap hoe het werkt. Het resultaat? Onze verkoop stijgt nog elk jaar. Frederiek blijft met nieuwe ideeën en handige tools komen om de shop verder te verbeteren ik hoef ze alleen nog maar in de praktijk te brengen. Vandaag geniet ik opnieuw van levenskwaliteit. Steeds meer processen zijn geautomatiseerd, waardoor de webshop ook 's avonds draait terwijl ik vroeger nog in de keuken stond te zwoegen. Ik heb nu al vele jaren een vast, trouw team, en dat allemaal dankzij die ene beslissing om vol in te zetten op de online shop en blindelings te vertrouwen in Frederiek. Zelfs vandaag breiden we nog uit. Onze levering is nu opgedeeld in zones, en Frederiek bouwde dat naadloos in onze shop in. Mijn ChatGPT is ondertussen omgetoverd tot Bastiano's eigen content studio weer zo'n slimme stap vooruit dankzij hem. Als ik sterren moest geven, waren vijf sterren veel te weinig. 10/10 maatje! Zonder Frederiek had ik dit nooit gehaald.
Eeuwig dank! Debby Swinnen - Zaakvoerder - Bastiano
Italiaanse keuken con tanto amore ❤️
Al vanaf het eerste gesprek met Frederiek van Clickforest wisten we dat we met de juiste persoon te maken hadden. Zijn aanpak is niet alleen doordacht en strategisch, maar ook verrassend confronterend, in de meest positieve zin van het woord. Hij wist meteen de vinger te leggen op pijnpunten waar wij zelf nog niet bij stil hadden gestaan. Frederiek beschikt over een indrukwekkende en diepgaande kennis van marketing, Shopify, Google en Meta. Wat hem écht onderscheidt, is zijn vermogen om al deze platformen naadloos met elkaar te integreren tot één krachtig geheel. Bovendien is Frederiek een uitermate aangename man om mee samen te werken. Hij is helder in zijn communicatie, denkt mee, is enthousiast én tegelijk realistisch. Kortom: wie op zoek is naar iemand die verder denkt dan standaardoplossingen én op een aangename manier naar het beste resultaat toewerkt, zit bij Clickforest meer dan goed.
ClickForest combineert AI, online marketing en e-commerce op een manier die je nergens anders vindt. Dankzij hun aanpak zie je snel tastbare resultaten.
Heel fijne samenwerking met het team van Clickforest. Ze luisteren echt naar je wensen, denken proactief mee en leveren kwaliteit af. Dankzij hun expertise hebben we mooie stappen gezet online. Absoluut een aanrader!
One stop shop mbt online marketing, ecommerce en AI. Professioneel agency. Op de hoogte van alle nieuwste ontwikkelingen. Denkt mee met de klant, en resultaatsgericht.
Als eigenaar van een klein bedrijf voelde SEO altijd als een afleiding van mijn werk, maar dat veranderde absoluut toen ik met Frederiek van ClickForest begon samen te werken. Ik ben van nature nogal sceptisch over digitale marketing, maar Frederiek behandelde mijn kleine bedrijf met dezelfde zorg die je zou verwachten van een grote, zakelijke klant. In plaats van in het duister te tasten, nam hij de tijd om me de basisprincipes uit te leggen, zodat ik mijn eigen website beter kon begrijpen. Die transparantie gaf me echt meer zelfvertrouwen en ik kreeg een nieuwe, waardevolle set tools. Hij ging heel goed om met het tijdsverschil tussen de VS en Europa en was altijd bereid om even te bellen wanneer het mij uitkwam. Hij werkte ook rechtstreeks samen met mijn webdeveloper om de technische zaken en on-page wijzigingen zonder problemen of downtime af te ronden. Onze zichtbaarheid is enorm toegenomen en ik heb eindelijk het gevoel dat ik onze organische groei onder controle heb. Als je in de Verenigde Staten woont en iemand zoekt die verstand van zaken heeft en echt om je bedrijf geeft, kan ik ClickForest van harte aanbevelen.
Clickforest is niet zomaar een digitaal bureau. Hun advies maakt echt het verschil. Elke aanbeveling voelt op maat gemaakt, uitvoerbaar en gebaseerd op echte ervaring. Ze pushen niet zomaar generieke marketingtactieken; ze nemen de tijd om je doelen te begrijpen en geven je duidelijke, gestructureerde begeleiding die daadwerkelijk resultaten oplevert. De kennis en het strategisch denken van het team hebben me tijd, geld en heel wat vallen en opstaan bespaard. Als je op zoek bent naar een partner die echte waarde levert in plaats van loze kreten, raad ik Clickforest van harte aan.
Het belangrijkste onderdeel van een succesvolle en winstgevende webshop is een team dat uw behoeften en ambities begrijpt. Met ClickForest beschikt u over een toegewijd team van experts dat u helpt bij het verfijnen van het hoe en waarom, samen met u uw strategie uitstippelt en deze combineert met indrukwekkende resultaten.
ClickForest combineert digitale efficiëntie, innovatie en menselijke waarden: het ideale bureau om de groei van uw bedrijf te versnellen en tegelijkertijd trouw te blijven aan uw behoeften en doelen.
Dankzij de tips van Clickforest over het gebruik van de juiste AI-tools is mijn productiviteit enorm toegenomen. De tips zijn op maat gemaakt en in begrijpelijke taal uitgelegd. Ik kan niet meer zonder! Ook mijn vervolgvragen werden snel en specifiek beantwoord. Hartelijk dank!
Deze klanten beoordeelden ClickForest ook met 5 sterren op Google