Veesie : mesurer si l'IA cite votre marque, chaque semaine, sans le bruit
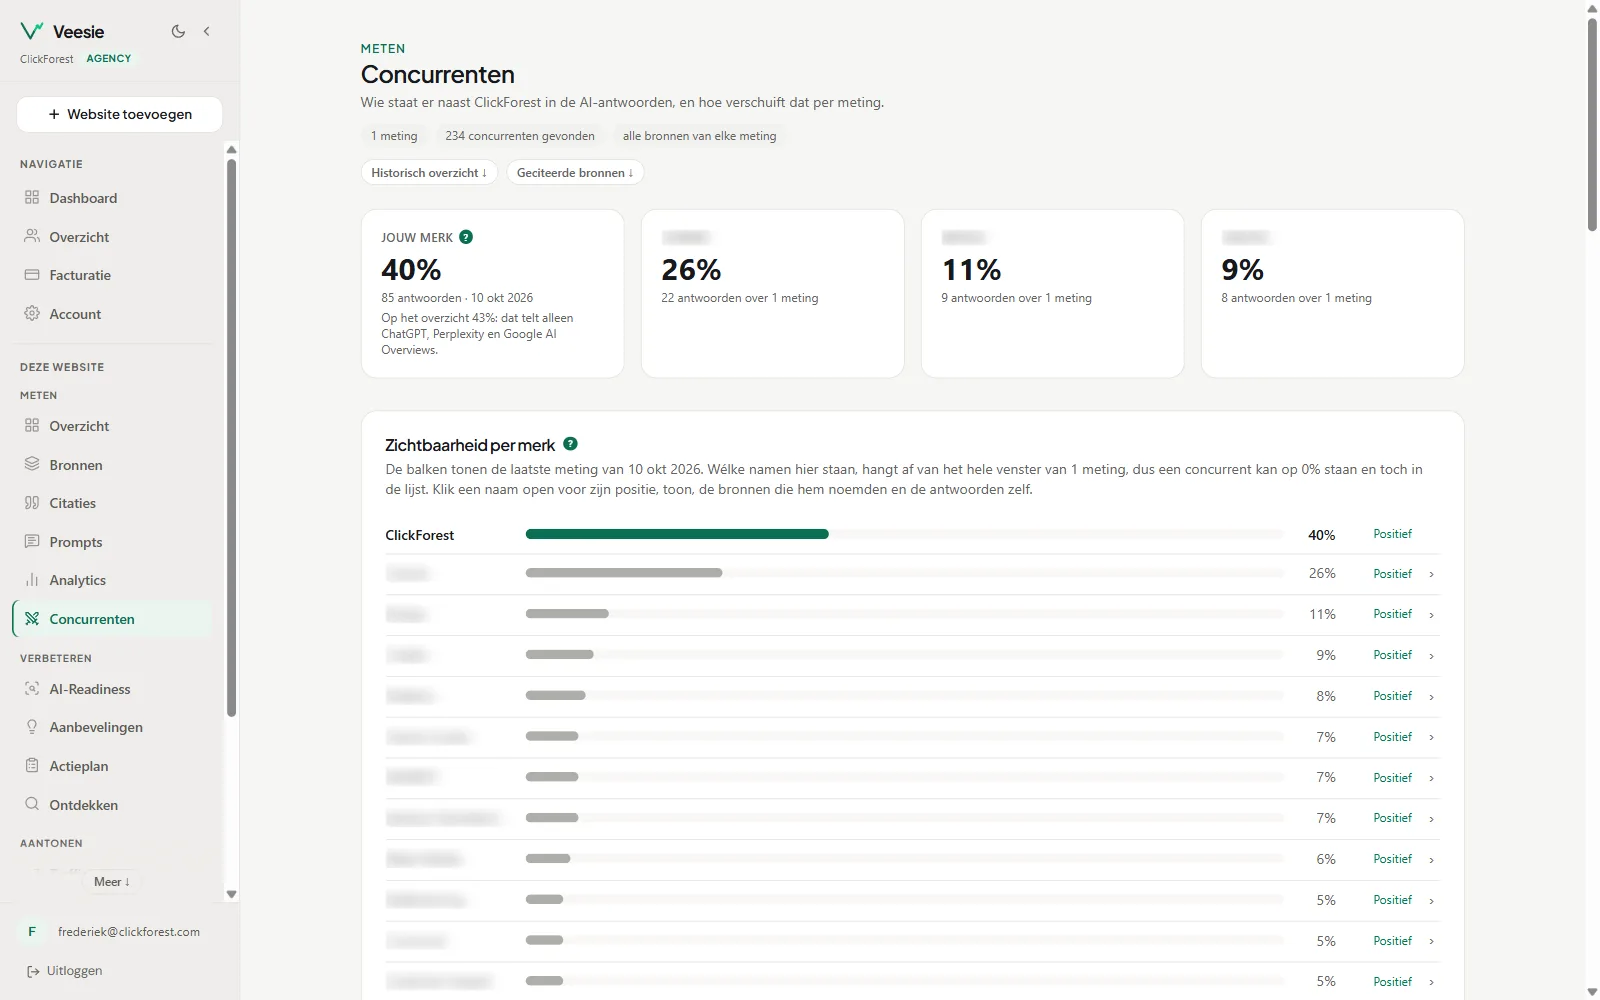
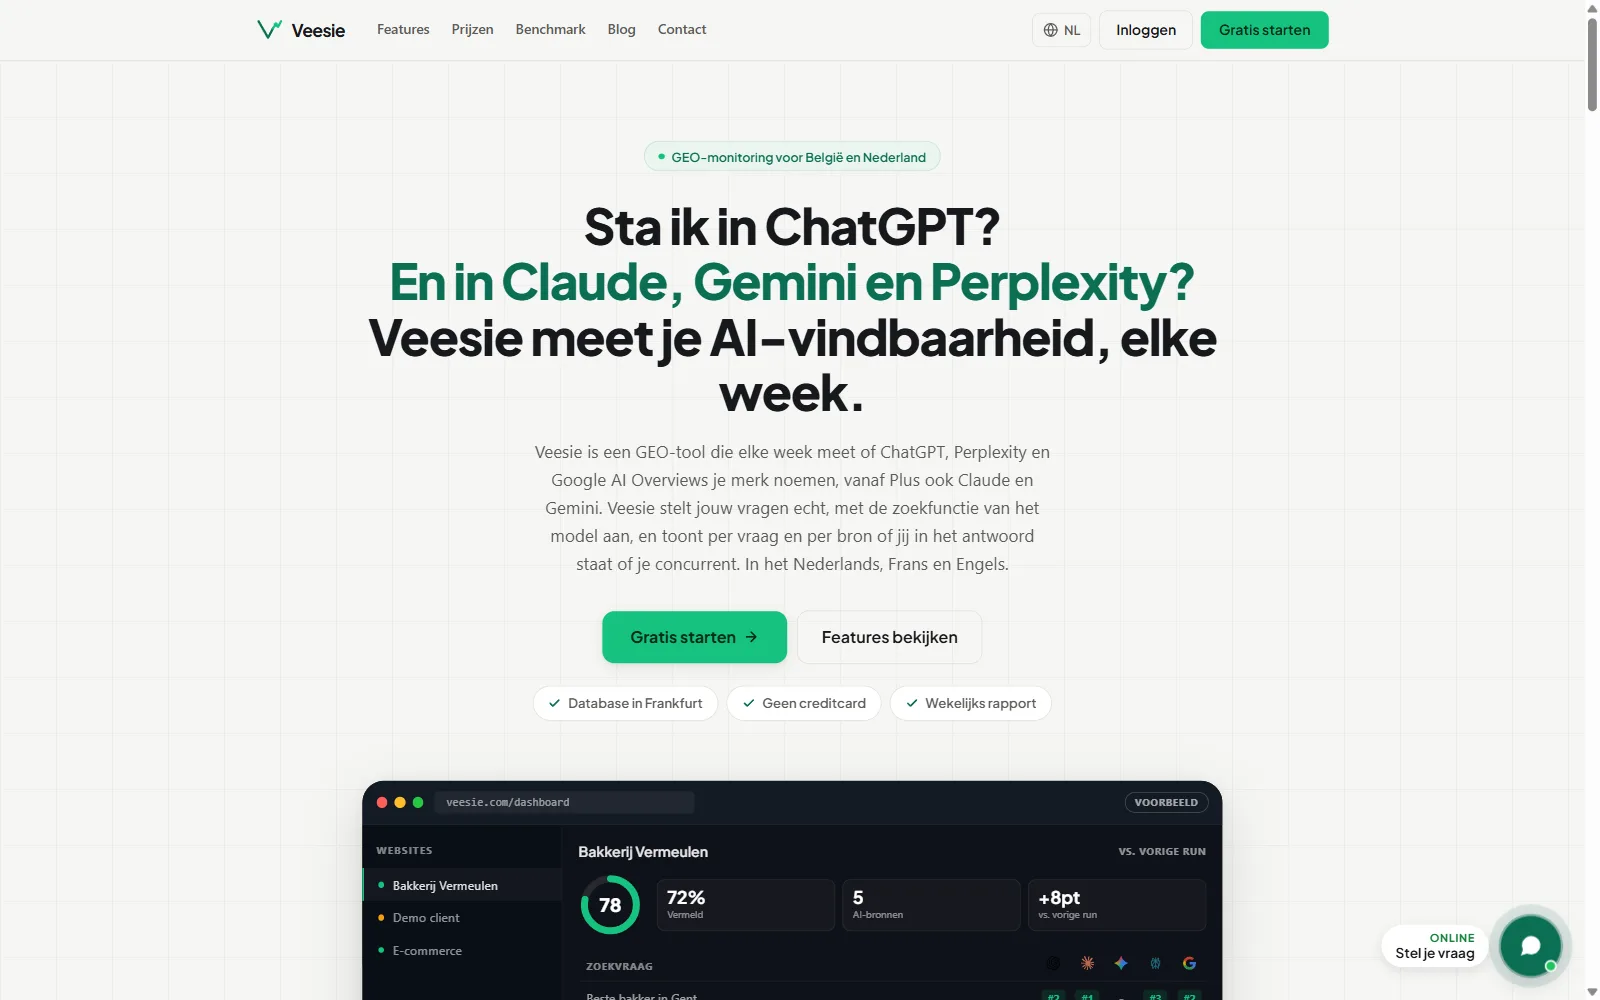
Veesie est notre propre marque SaaS, construite de zéro. Elle pose à ChatGPT, Claude, Gemini, Perplexity et Google AI Overviews les questions que posent vos clients, avec la fonction de recherche du modèle activée, et compte qui figure dans la réponse. Chaque semaine, en néerlandais, en français et en anglais, et conçue pour qu'une réponse fortuite ne détermine pas votre chiffre.
Posez deux fois la même question à un assistant IA et vous obtenez deux réponses. Mesurer cela sans répétition, c'est mesurer le hasard.
Défi
De plus en plus de clients demandent une recommandation à un assistant IA au lieu de parcourir dix liens bleus. Une entreprise veut donc savoir si elle figure dans ces réponses, à côté de qui, et si cela s'améliore. Seulement, une réponse IA varie à chaque fois, selon le modèle et selon la langue, et un instantané ne vaut alors pas grand-chose. La question était de savoir si l'on peut en tirer un chiffre qui ait du sens, et ce chaque semaine.
Approche
De vraies questions, posées en direct avec la fonction de recherche du modèle activée, sur cinq sources. De la répétition là où les modèles varient le plus, un panier fixe de trois sources pour le score afin que votre courbe ne saute pas, et tout ce qui ne demande pas de jugement dans le code. Construit avec Claude Code, et surveillé par une suite de tests qui a grandi avec chaque fonctionnalité : 521 fichiers de test au moment de cette étude de cas.
5
sources IA par question : ChatGPT, Claude, Gemini, Perplexity et Google AI Overviews
4 points
d'écart entre la plus haute et la plus basse de cinq mesures identiques sur une journée (25 août 2026, 12 questions) : 85, 87, 84, 88 et 85
0
mention manquée à la lecture de 655 réponses (test du 24/08/2026)
521
fichiers de test dans le dépôt, avec les prix, les limites des formules et les connaissances du chatbot comme faits surveillés
De vraies questions, recherche activée
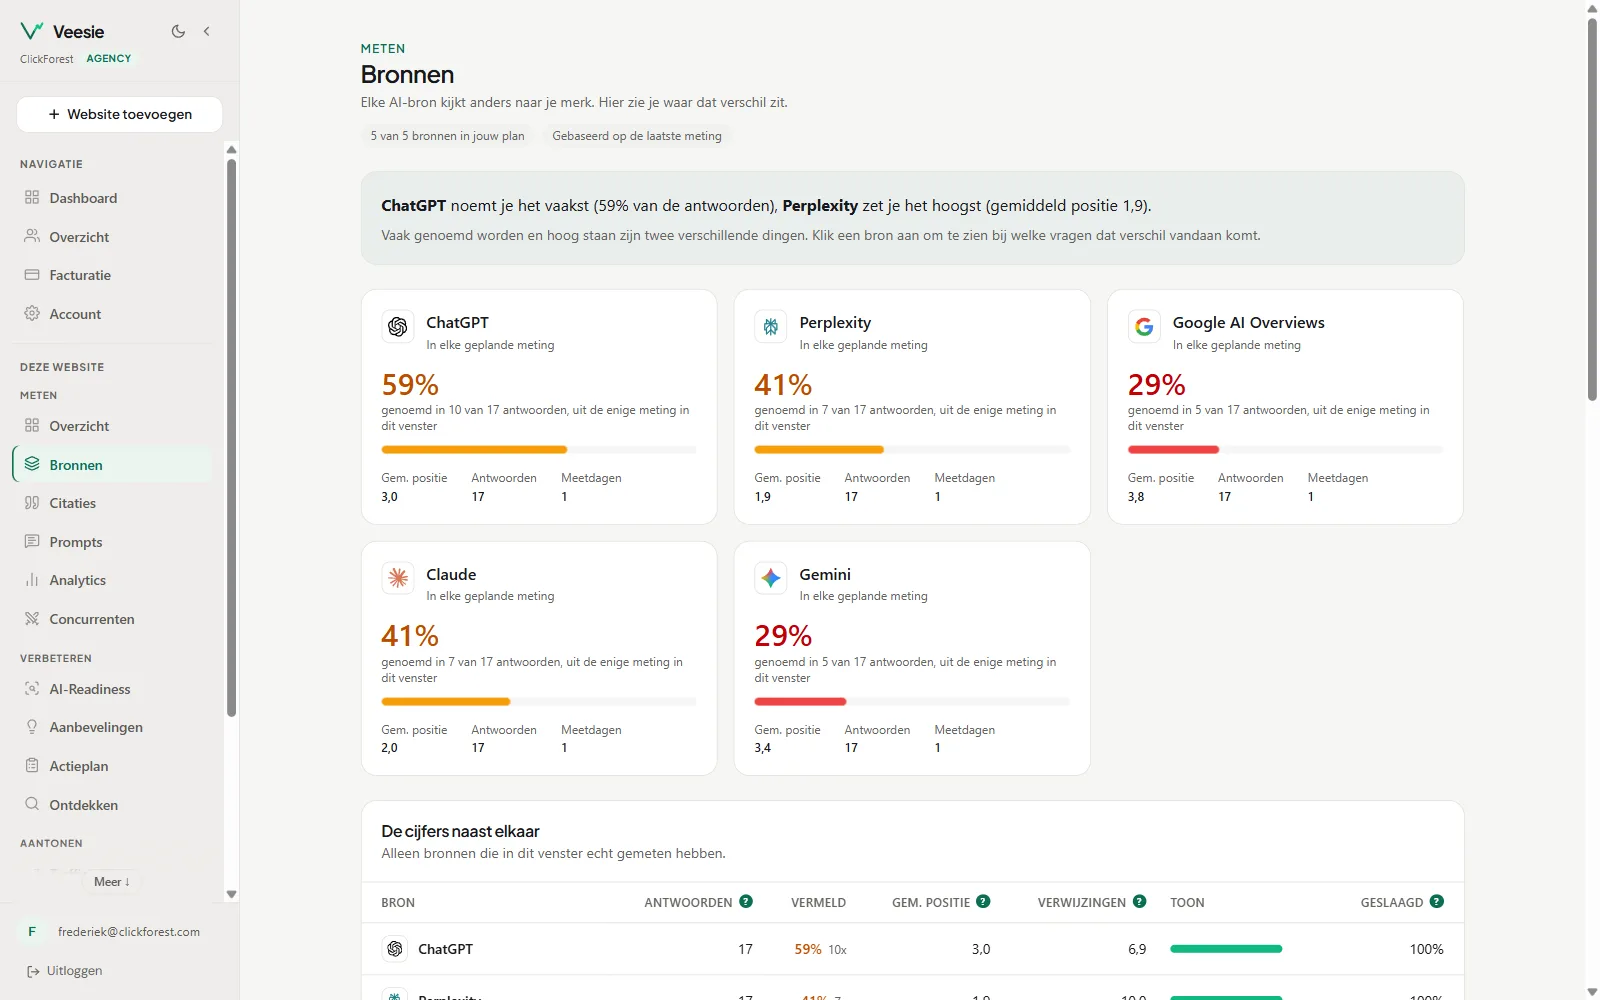
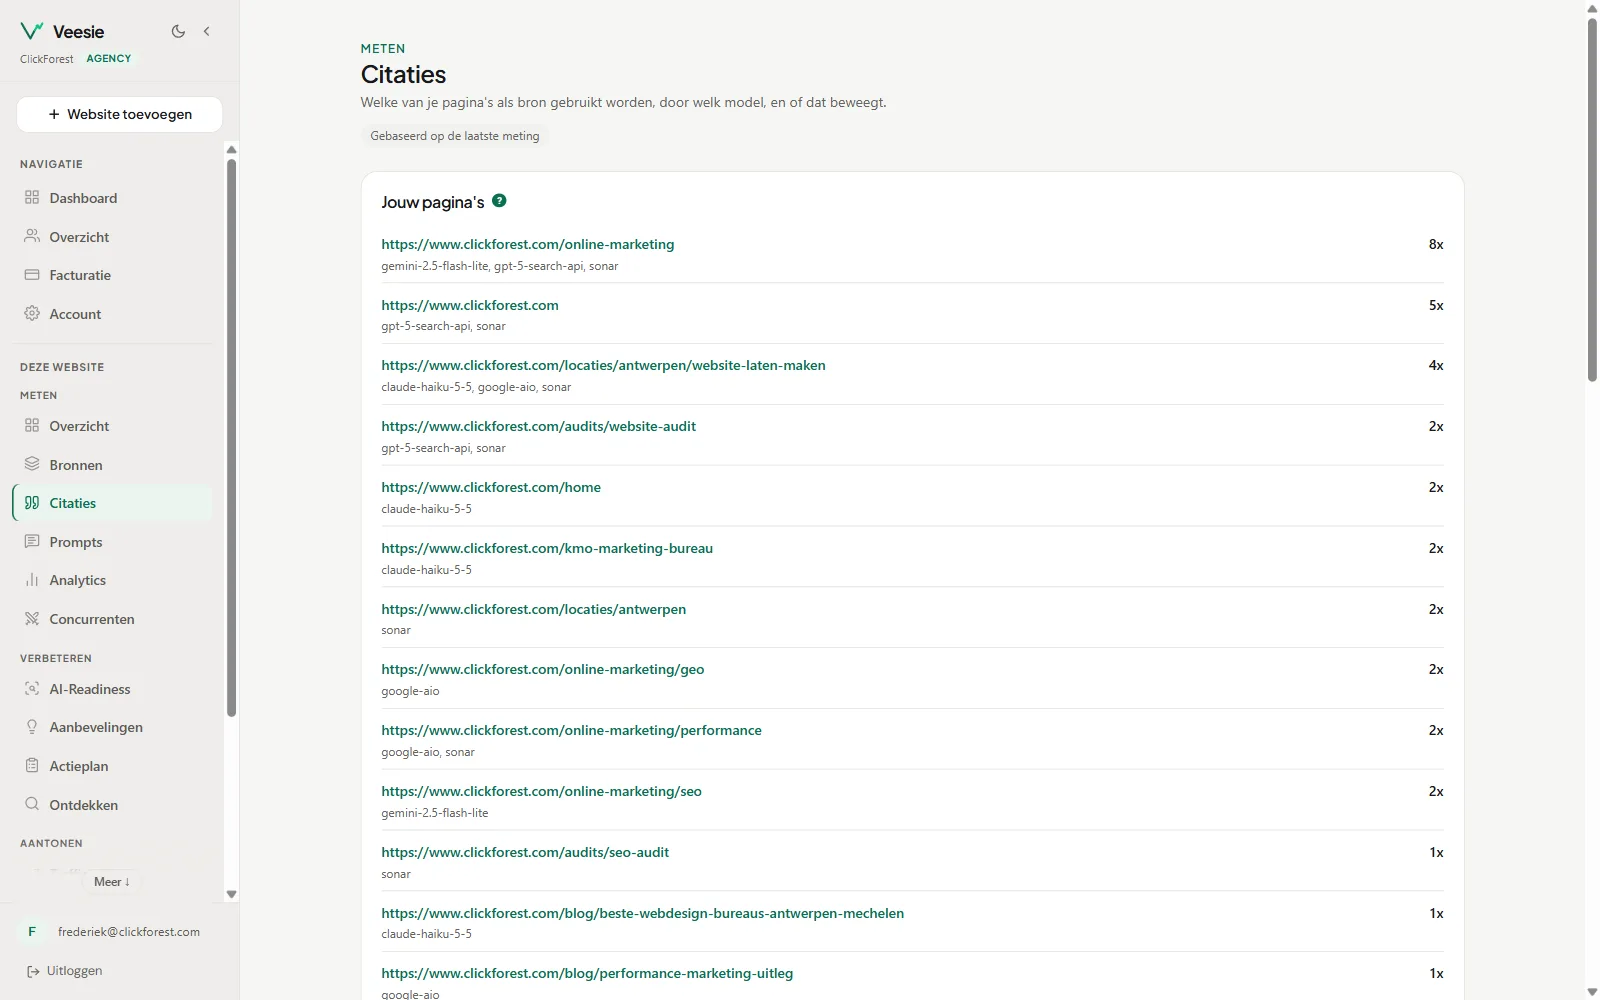
Chaque question part en direct vers la source, avec la recherche activée : gpt-5-search-api pour ChatGPT, sonar pour Perplexity, Claude Haiku 5.5 et Gemini 2.5 Flash-Lite avec recherche web, et Google AI Overviews directement depuis les vrais résultats Google via DataForSEO. Quand le modèle cite des sources, Veesie les conserve avec la réponse, sous forme de lien cliquable. Vous voyez ainsi non seulement si vous êtes cité, mais aussi quelles pages l'IA a lues pour cela.
Pour chaque réponse, Veesie enregistre si la marque est citée, à quelle position, dans quel contexte et avec quel sentiment. L'extraction a été testée sur 655 réponses en sept jours : zéro mention manquée qui figurait littéralement dans le texte, zéro mention sans fondement.
Une mesure, c'est du bruit, cinq mesures montrent la tendance
Le 25 août 2026, Veesie a lancé cinq mesures identiques sur clickforest.com : 12 questions, cinq sources, en moins d'une heure, avec les modèles de l'époque (Claude Haiku 4.5 ; depuis le 8 octobre 2026, Veesie mesure avec Haiku 5.5). Le score est resté stable : 85, 87, 84, 88 et 85. En dessous, beaucoup de choses changeaient. Pour 14 des 60 combinaisons de question et de source, la réponse différait d'une fois à l'autre, et 10 de ces 14 venaient de Claude et Gemini.
Cinq mesures identiques sur clickforest.com, 25 août 2026, 12 questions.
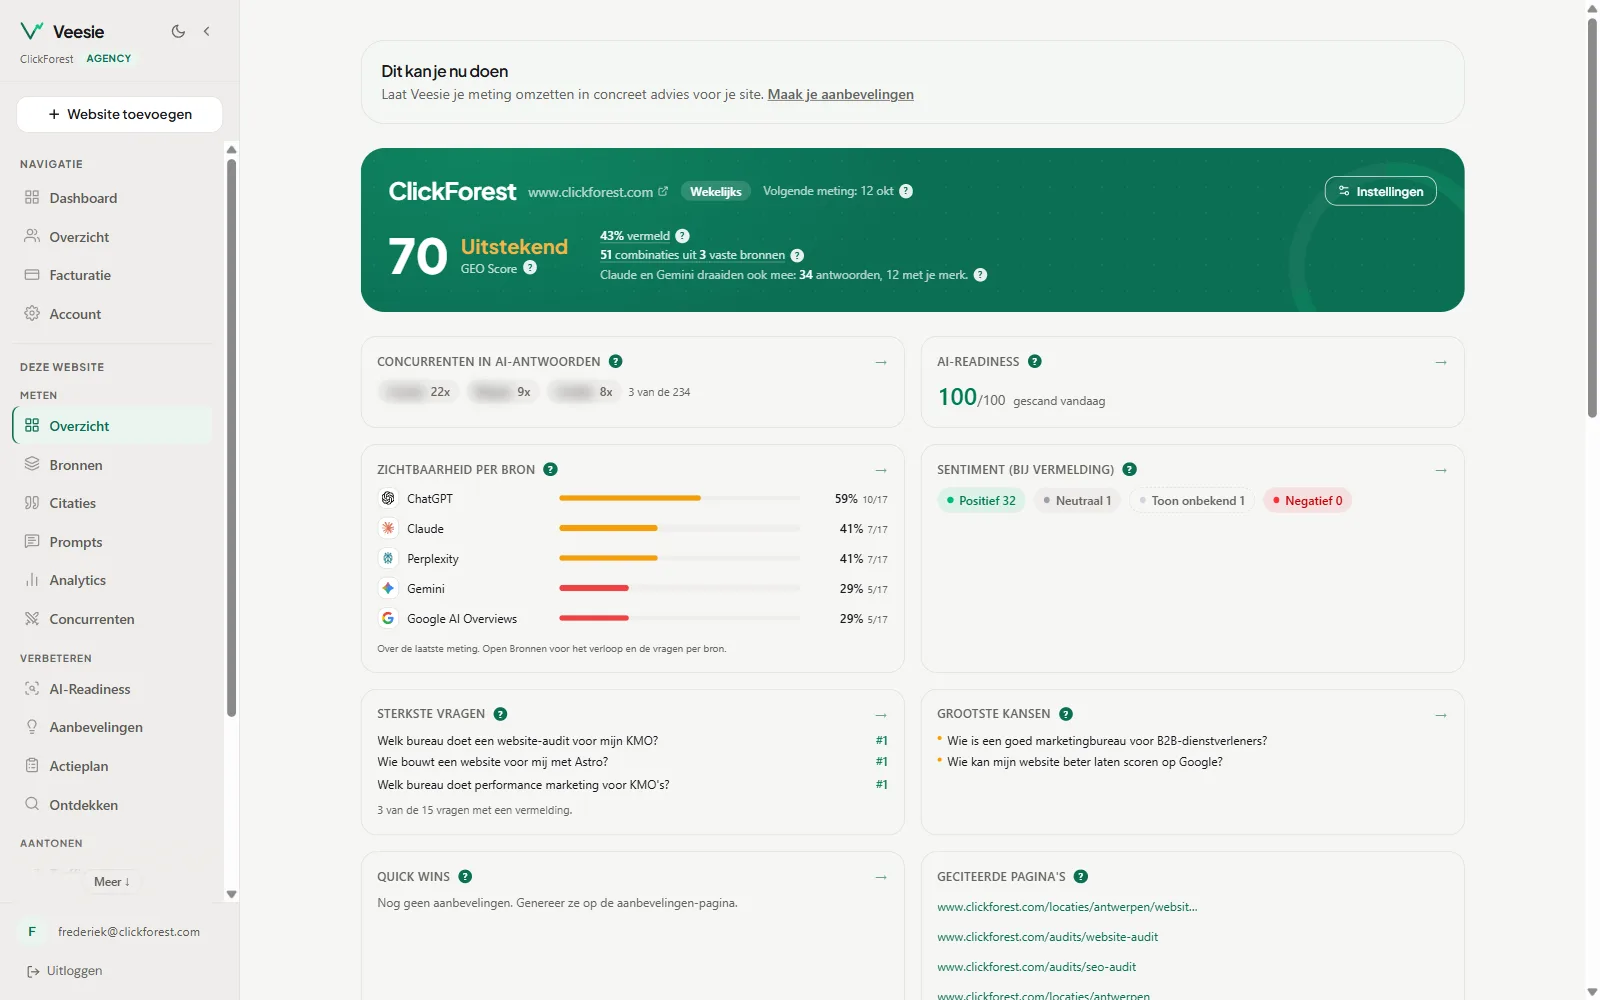
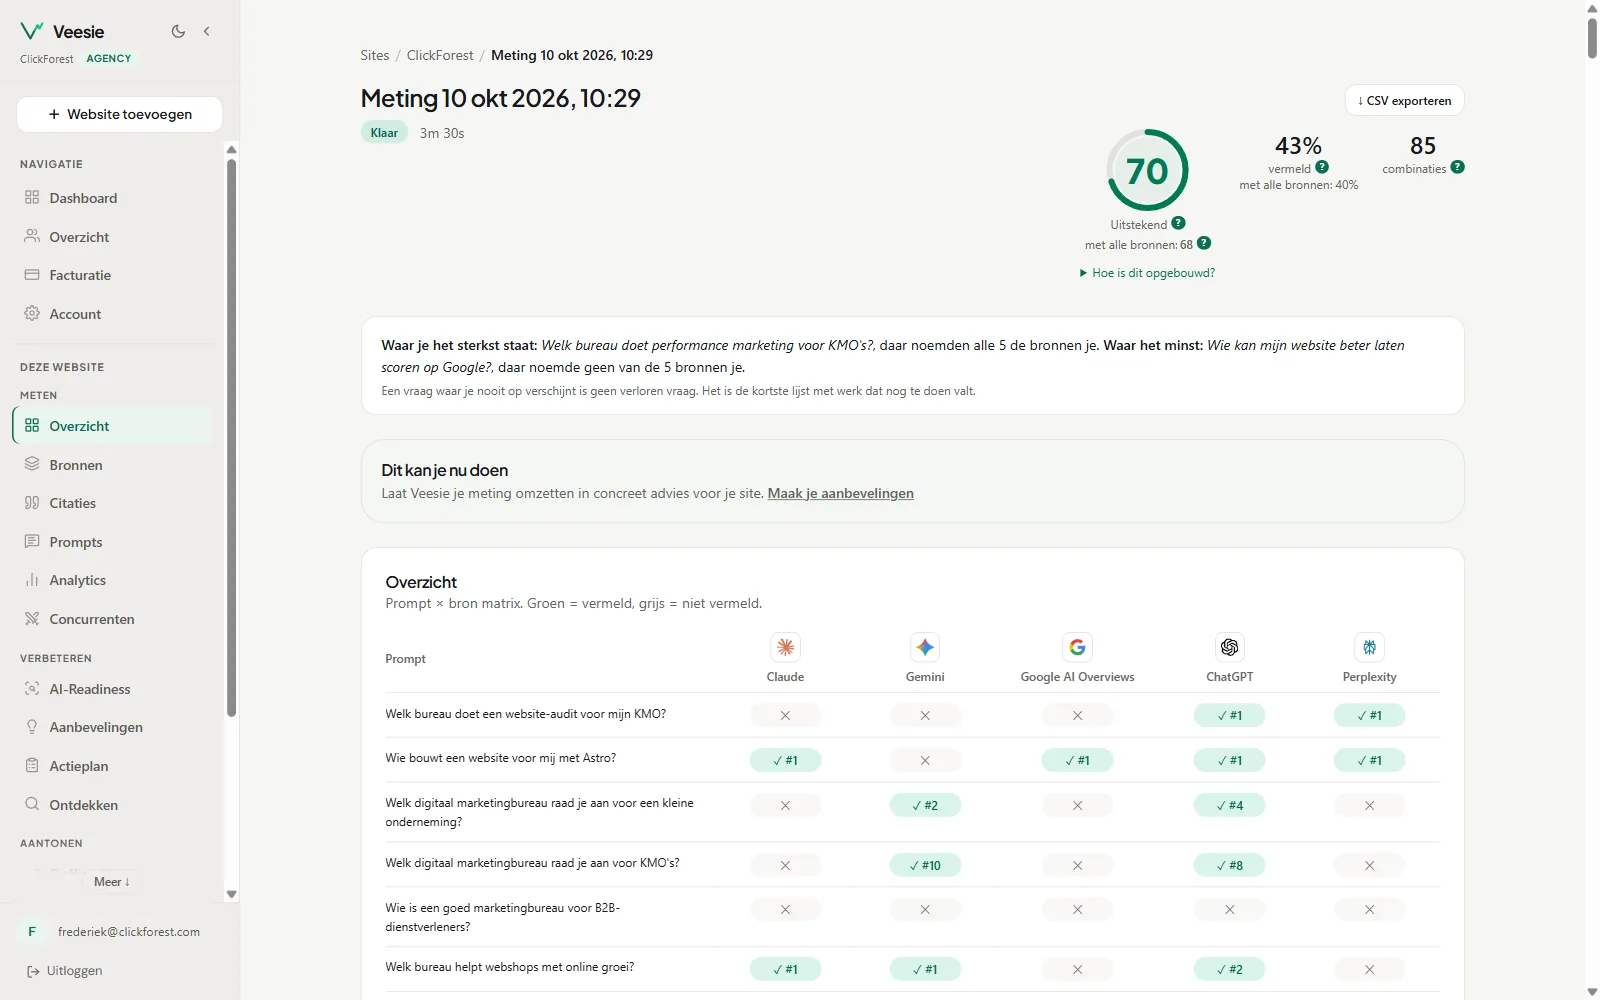
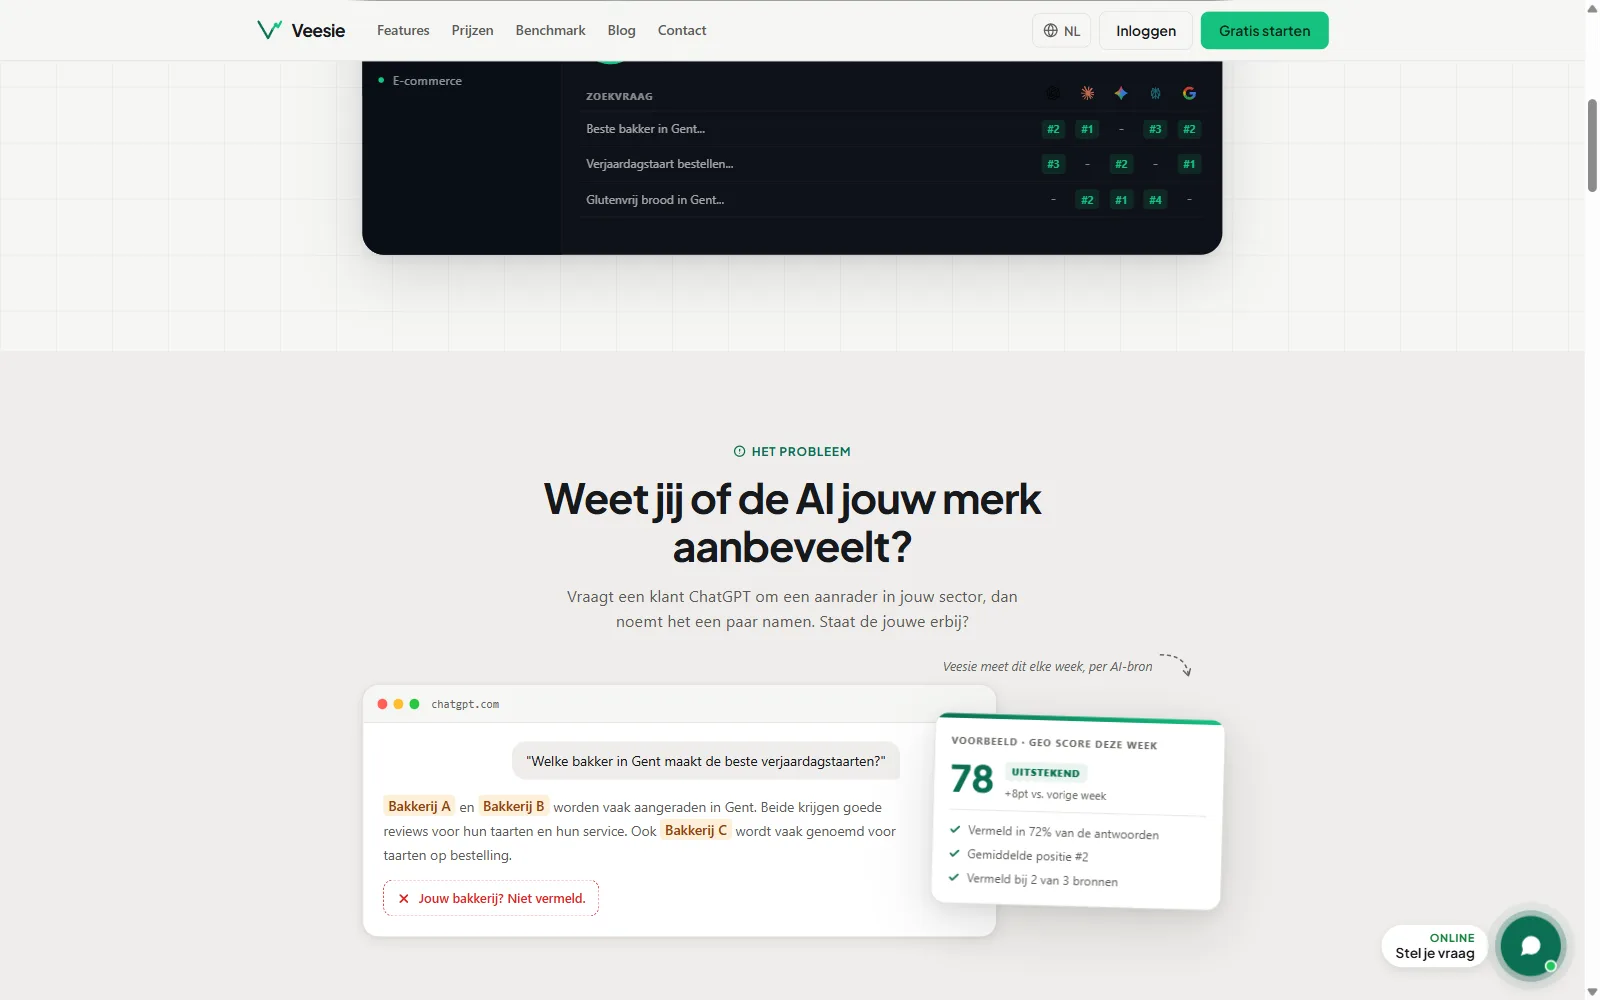
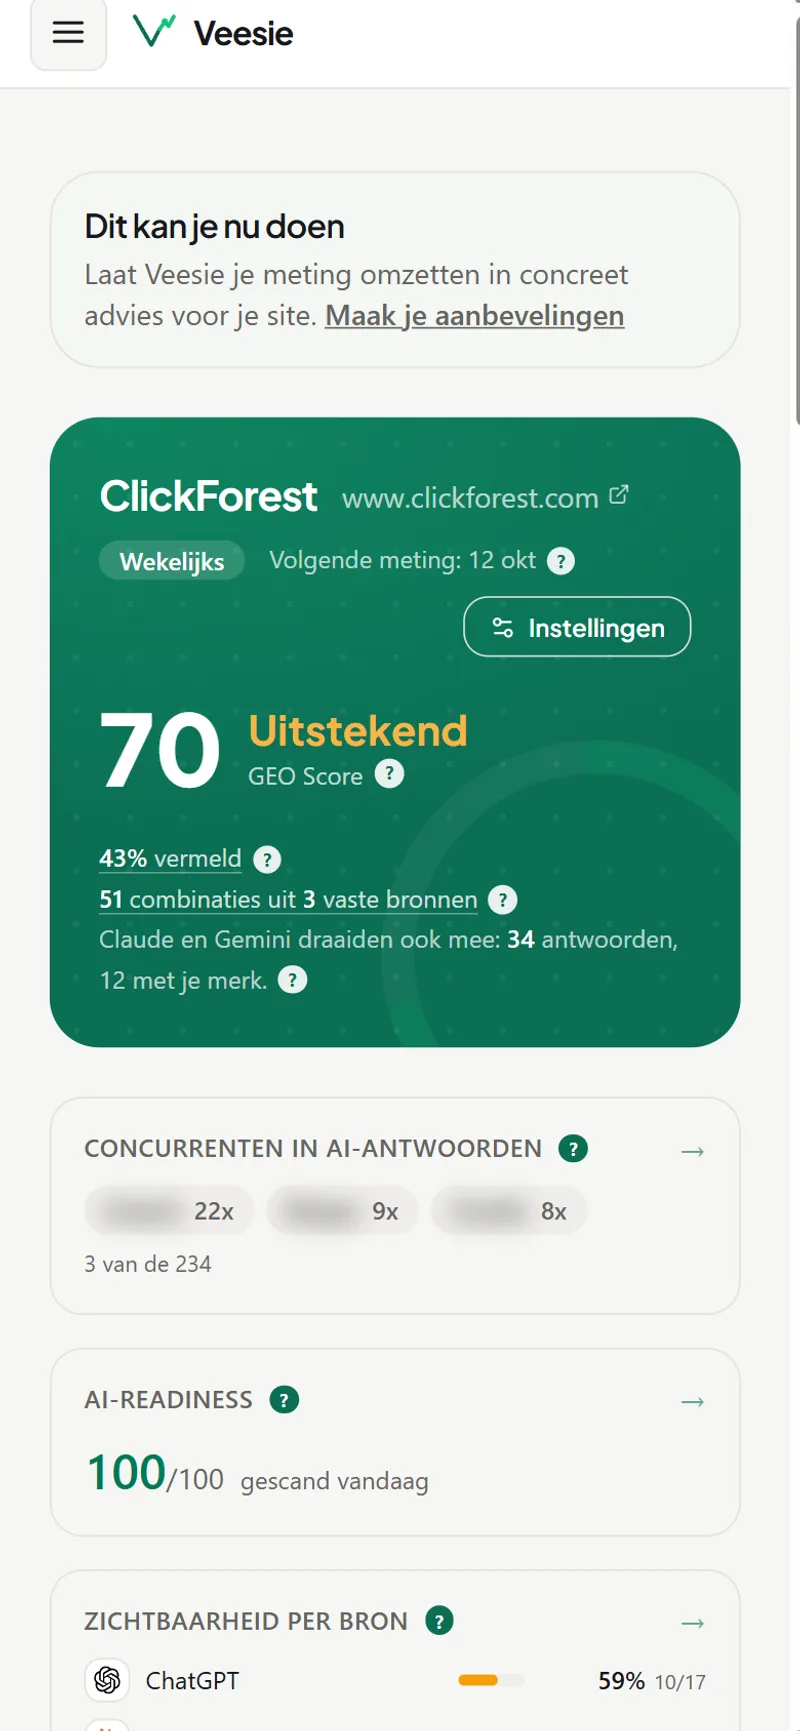
Ce test porte sur la stabilité du chiffre pour les mêmes questions, pas sur le niveau. Le tableau de bord dans la galerie montre une nouvelle mesure du 10 octobre 2026 sur 17 autres questions, que Veesie a déduites du site, et clickforest.com y obtient 70. Un autre jeu de questions donne un autre niveau.
Deux choix de conception en ont découlé. Claude et Gemini reçoivent chaque question jusqu'à trois fois, et Veesie retient la majorité. Et l'hebdomadaire est devenu le maximum sur chaque formule : mesurer plus souvent ne change presque rien au chiffre, ce qui change, c'est votre site. Pour cela, il existe une mesure supplémentaire à la demande, après une modification.
Un score qui ne saute pas
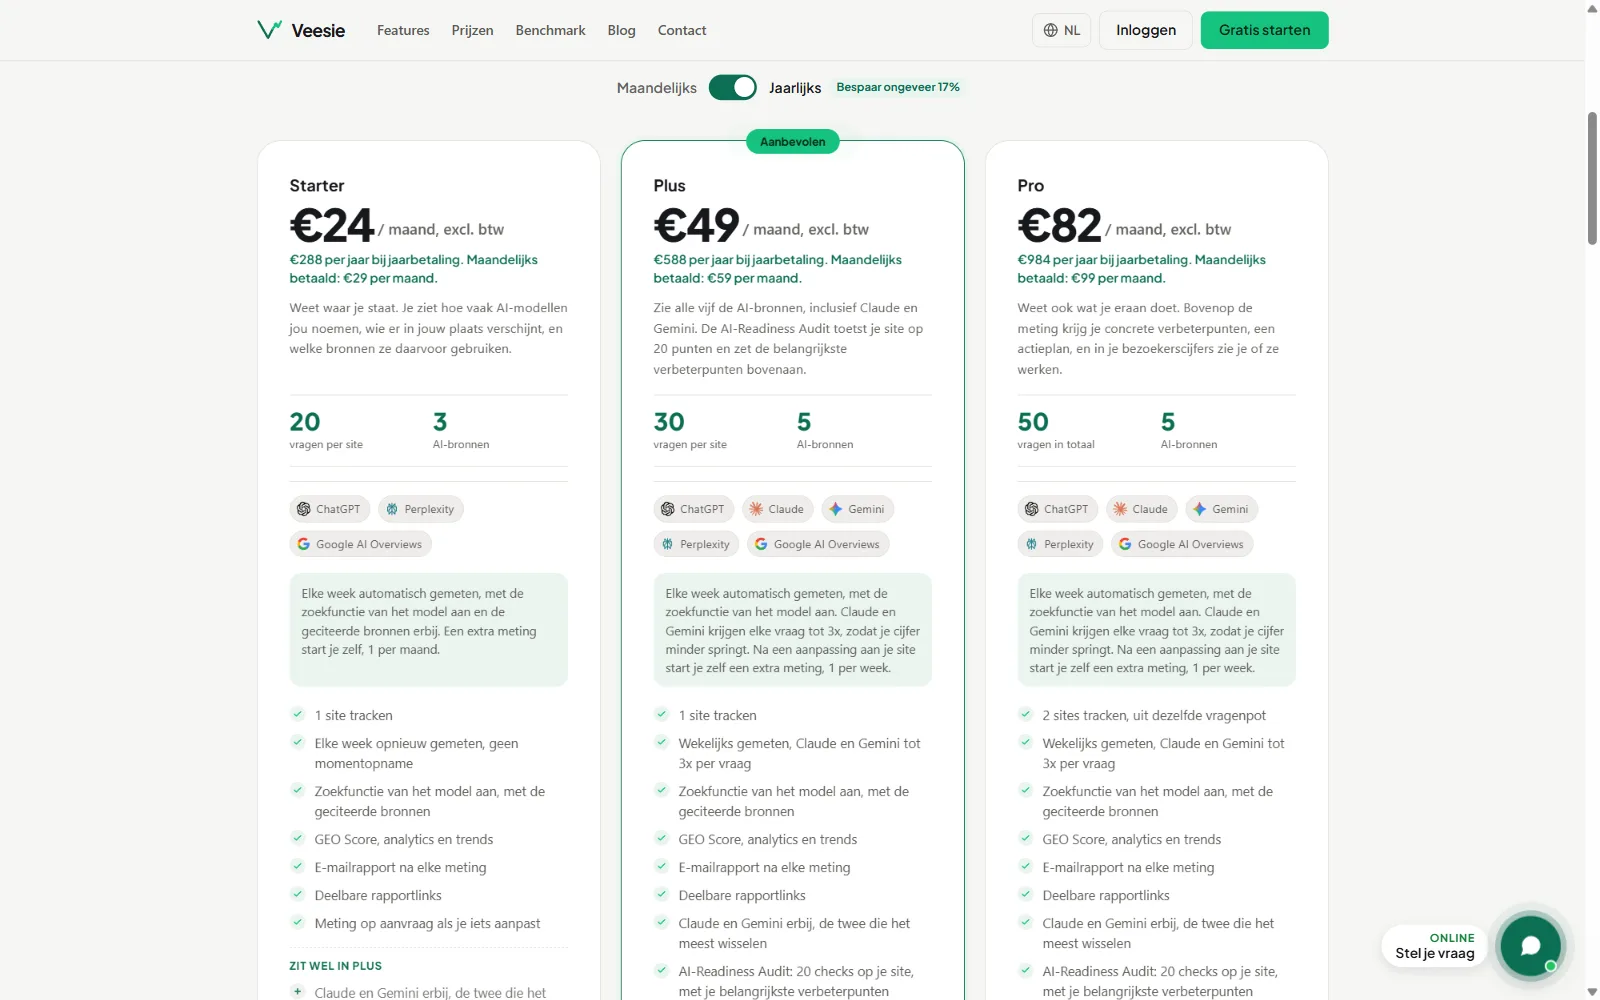
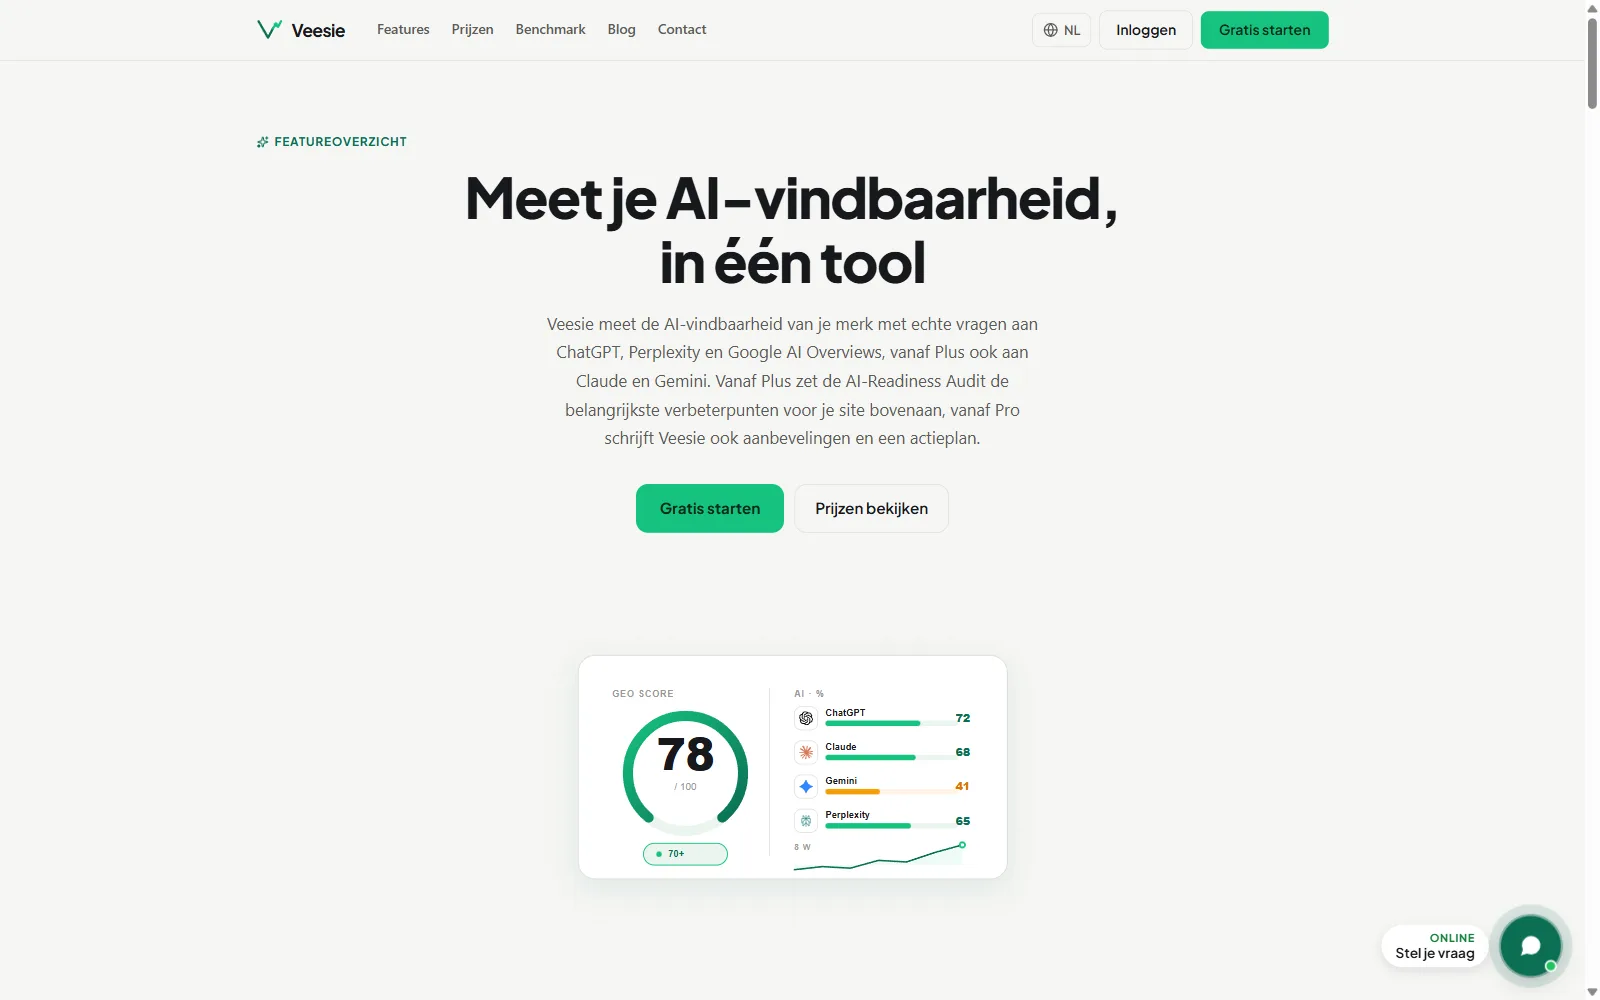
Le GEO Score est un indice propre de 0 à 100, et c'est pourquoi la formule est publique (veesie.com/features) : 50 % taux de mention, 25 % sentiment, 15 % couverture des sources et 10 % position dans la réponse. Sur chaque formule, le score se calcule sur les trois mêmes sources : ChatGPT, Perplexity et Google AI Overviews. Claude et Gemini sont mesurés et affichés dès Plus, mais ne comptent pas. Qui change de formule ne voit donc pas sa courbe sauter à cause d'un autre panier.
50251510
Taux de mention 50 %
Sentiment 25 %
Couverture des sources 15 %
Position 10 %
De la mesure au conseil
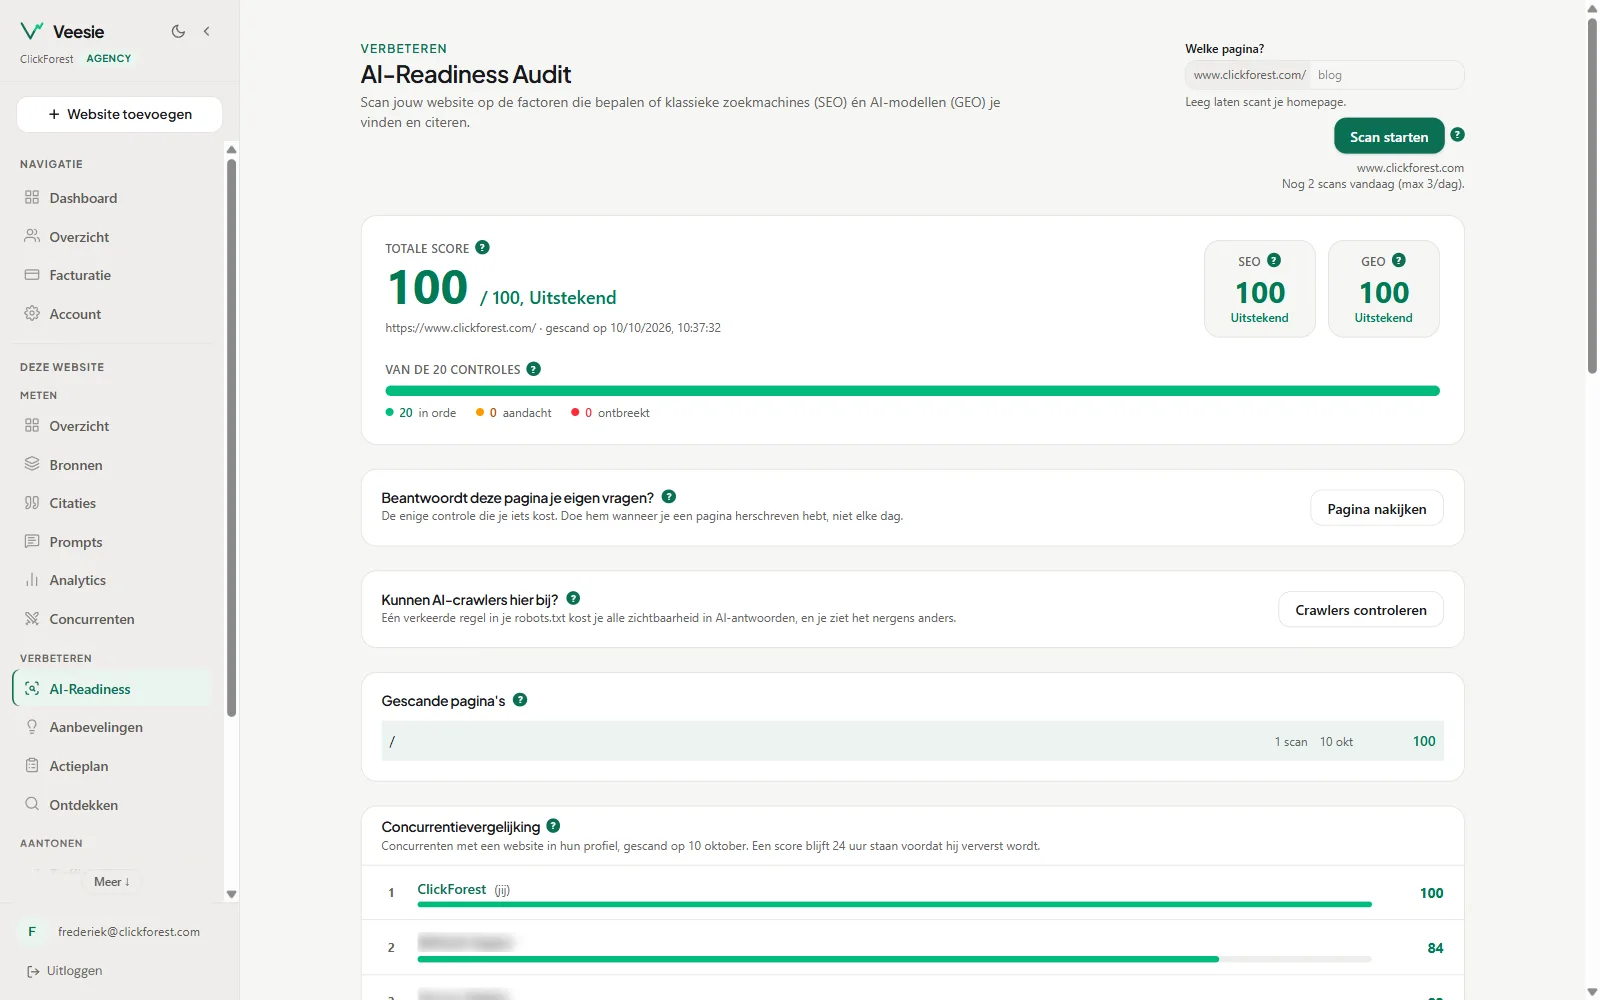
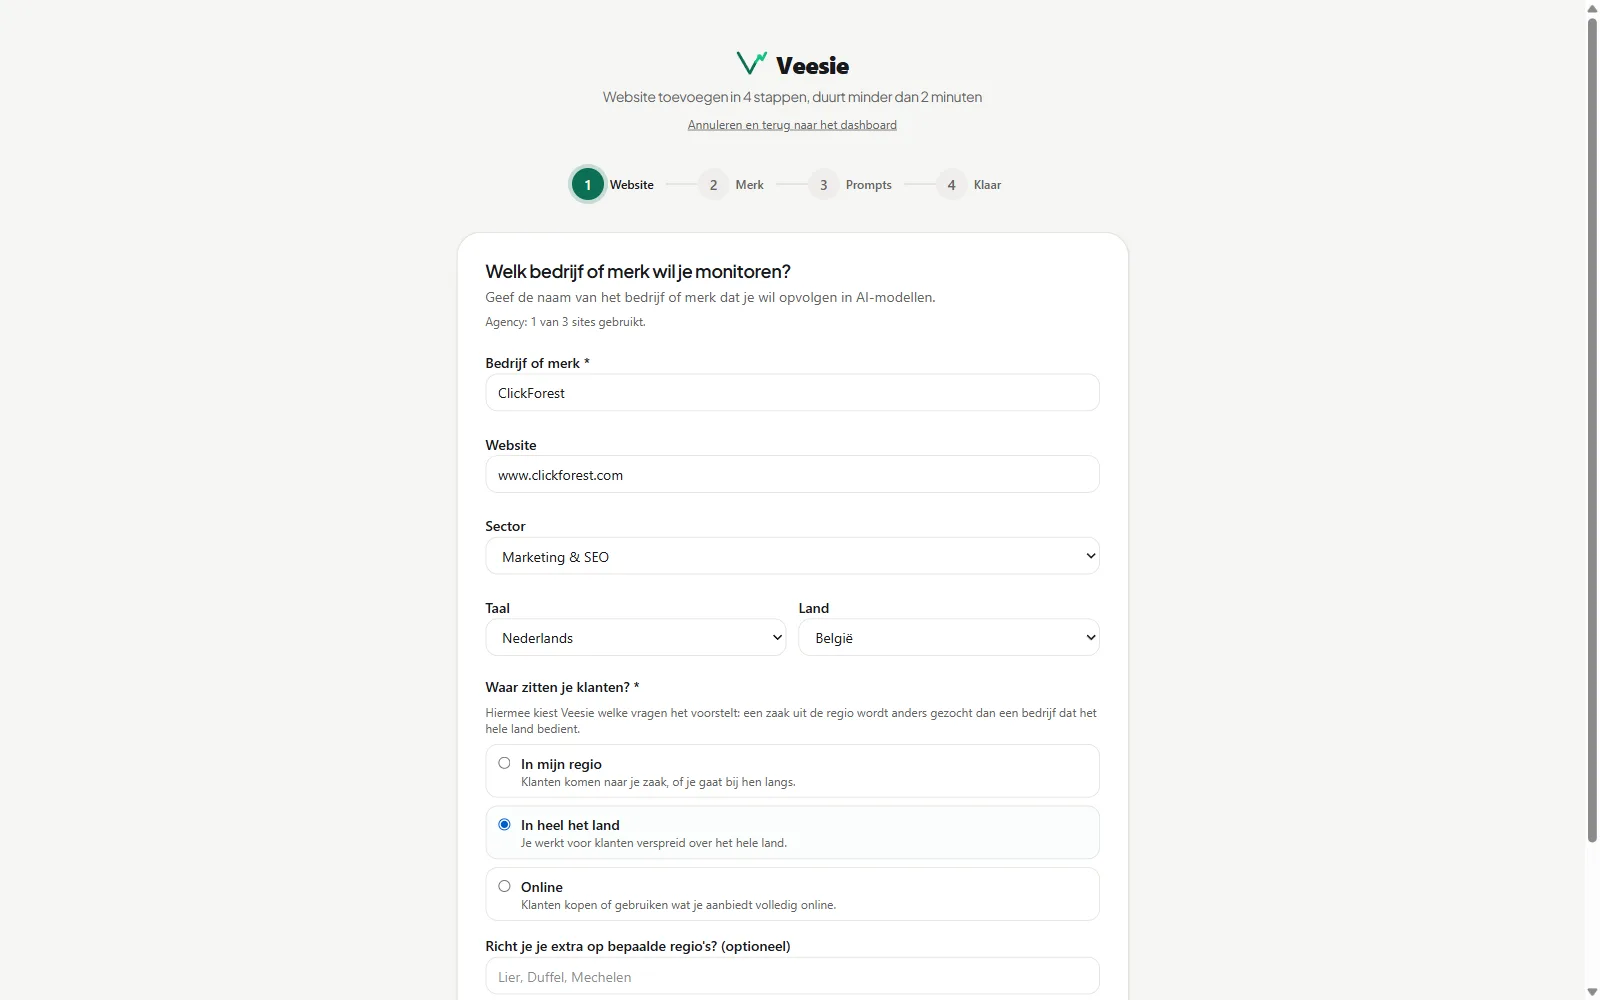
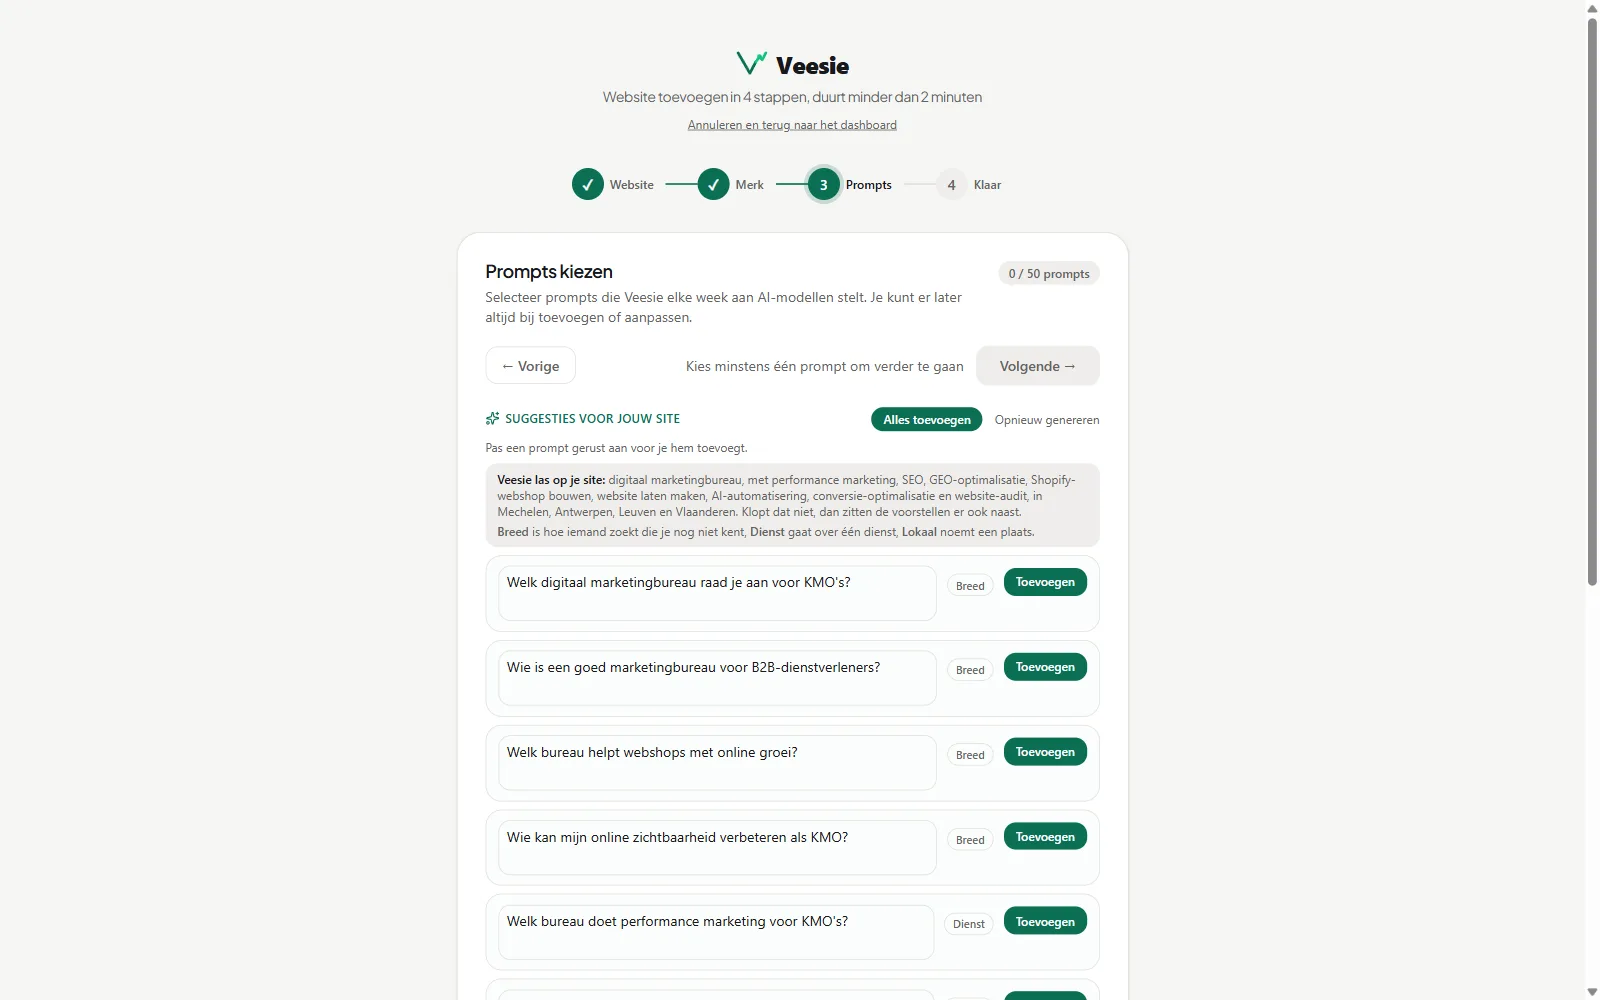
Mesurer, c'est la moitié du travail. À l'ajout d'un site, Veesie lit le site lui-même et propose des questions de trois types : larges, par service et locales. Dès Plus, l'AI-Readiness Audit évalue le site sur 20 contrôles, dix pour le SEO et dix pour le GEO, et place les principaux points d'amélioration en tête. Dès Pro, Veesie rédige des recommandations GEO à partir des cinq dernières mesures, les intègre dans un plan d'action, et la connexion GA4 montre dans vos propres chiffres de visites combien de trafic l'IA apporte. Cette connexion lit Google Analytics avec le scope analytics.readonly, vérifié par Google le 24 août 2026.
Veesie a été construit avec Claude Code, du premier commit le 25 avril 2026 au lancement public en octobre : 1 927 commits et 100 migrations de base de données. Ce qui le rend fiable, c'est la suite de tests en dessous. Outre la logique de mesure, elle vérifie aussi les faits que lisent les visiteurs. Les prix et les limites des formules viennent d'un seul fichier de configuration, et les tests échouent si un texte ou le chatbot promet une fonctionnalité que la formule n'a pas, ou cite un nombre qui n'est plus correct. Un chatbot qui ne connaît pas une fonctionnalité ne dit pas « je ne sais pas ». Il répond avec la même assurance à partir de ce qu'il a. Ses connaissances sont donc testées elles aussi.
Un outil GEO doit lui-même être cité correctement
Un outil qui mesure la visibilité dans l'IA est lui-même décrit par l'IA. Le 9 octobre 2026, un assistant IA a montré Veesie dans une comparaison avec le mauvais logo et a cité le prix annuel comme prix mensuel. La cause se trouvait probablement sur notre propre site : un balisage schema qui décrivait deux marques comme une seule entité, et une page de prix qui affichait le prix annuel en grand sans le préciser. Le jour même, il y avait des phrases citables par formule, des FAQ sur exactement ces malentendus, un schema corrigé et un ping IndexNow pour les 69 pages. Des tests veillent à ce que cela ne revienne pas.
Ce que coûte son fonctionnement
Veesie utilise le modèle le moins cher de chaque famille, avec la recherche activée. Avec la recherche web, c'est la couche de recherche qui détermine la réponse plus que la taille du modèle, et cela rend possible une mesure hebdomadaire à partir de 29 € par mois. Le coût par mesure n'est pas estimé mais calculé à partir de mesures réelles et des tarifs par modèle, et revérifié à chaque changement de modèle. Les mesures elles-mêmes passent par Inngest, avec une étape distincte par combinaison de question et de source, afin qu'une mesure de 85 combinaisons ne se heurte pas à la limite de temps d'un seul Worker.
Ce que nous ne prétendons pas
Pas de résultats clients. Veesie est ouvert au public depuis octobre 2026. Les chiffres sur ce que les clients en ont obtenu viendront quand ils existeront.
Pas un miroir de l'application grand public. Veesie utilise le modèle le moins cher de chaque famille, avec la recherche activée. La marque qu'un modèle cite en premier peut différer de ce que quelqu'un voit aujourd'hui dans l'application. Comme mesure relative, semaine après semaine, la mesure est fiable.
Un seul test de stabilité, sur un seul site. La série 85, 87, 84, 88 et 85 vient de clickforest.com, une marque souvent citée. Pour une marque qui n'apparaît presque nulle part, le chiffre saute relativement plus : sur veesie.com, le même type de mesure est passé de 0 à 22.
Pas un standard du secteur. Le GEO Score est un indice propre. C'est pourquoi la formule figure sur le site, pour que vous sachiez ce que signifie une hausse.
Veesie lui-même est encore à peine cité. Une nouvelle marque doit encore construire cette visibilité, et Veesie la mesure aussi pour lui-même, chaque semaine.
Le tableau de bord est en néerlandais pour l'instant. Veesie mesure des questions en néerlandais, en français et en anglais, mais le tableau de bord lui-même n'est disponible qu'en néerlandais pour le moment.
Cinq sources, chaque semaine
ChatGPT, Claude, Gemini, Perplexity et Google AI Overviews, interrogés en direct avec la recherche activée, en néerlandais, en français et en anglais.
La répétition contre le bruit
Claude et Gemini reçoivent chaque question jusqu'à trois fois. Cinq mesures identiques sur une journée ont donné 85, 87, 84, 88 et 85.
Des faits testés
Les prix, les limites des formules et ce que dit le chatbot viennent d'une seule source et sont surveillés par la suite de tests.
Outils utilisés
Claude Code (construire avec l'IA)
Next.js 15 et React 19, via OpenNext sur Cloudflare Workers
Supabase (Postgres et Auth) à Francfort
Inngest pour les mesures, avec une étape par question et par source
OpenAI, Anthropic, Google, Perplexity et DataForSEO comme sources IA
Stripe pour les abonnements, Resend pour les e-mails
Cloudflare Turnstile et Sentry
Bon à savoir avant de lancer un essai gratuit : le tableau de bord de Veesie n'est disponible qu'en néerlandais pour le moment.
Une véritable recommandation ! Frederiek possède une expertise étendue et travaille de manière extrêmement professionnelle. Il est réellement engagé à nous aider, en tant que client, à tirer le meilleur parti de notre site web et de notre marketing digital. Il prend la peine de nous connaître en tant qu'entreprise et de traduire cela en visibilité numérique, avec un impact réel pour nous. Une communication très claire et une collaboration agréable.
Une expérience vraiment agréable avec ClickForest. Dès le départ, une explication claire du déroulement et de l'avenir du paysage numérique. Une expertise manifeste et un contact très direct et personnel. La communication a été très fluide et le devis transparent a posé les bases de notre collaboration. Pendant le projet, nous avons remarqué à quel point Frederiek réagit vite. Chaque e-mail et chaque question sont suivis en un rien de temps, que ce soit par WhatsApp, par téléphone ou par e-mail. Jour après jour, nous avons vu notre boutique évoluer dans la bonne direction. Les retours étaient suivis et partagés avec nous très rapidement. Pas des semaines d'attente pour une réponse, mais un contact personnel en tête-à-tête, toujours avec la même personne. C'est comme ça que ça doit être !
Un client satisfait, et qui le restera !
Après avoir consulté plusieurs créateurs de sites web, notre choix s'est porté sur "ClickForest". Pas le moins cher, mais une approche directe et personnelle. Grâce à une bonne collaboration avec Frederiek, notre nouveau site "Servaes Services" a été lancé rapidement et efficacement, et nous les recommandons vivement.
Service excellent et un résultat final magnifique. Mon site web a été construit de manière professionnelle, avec beaucoup d'attention pour le détail et la convivialité. Communication fluide, exécution rapide et une collaboration très agréable. Vivement recommandé !!!
Dès notre première conversation, j'ai immédiatement eu un bon feeling avec Frederiek. La passion et le dévouement qu'il met dans son travail et ses projets m'ont même ému à plusieurs reprises. Il possède une expérience et des connaissances immenses, et cela se ressent ! De plus, il est ouvert au dialogue et toujours réactif, si bien que chaque petite étape semble un grand bond en avant. Ce qui me touche le plus, c'est sa vision à long terme. Dès le début de notre collaboration, on sent qu'il ne cherche pas simplement à livrer du travail et envoyer une facture. Il réfléchit avec moi à là où je veux emmener mon projet dans un an, trois ans, cinq ans et au-delà. Merci pour tout ton magnifique travail jusqu'à présent, Frederiek, et j'espère que nous pourrons collaborer avec succès encore de nombreuses années !
Il y a cinq ans, j'ai tout misé et réalisé un investissement conséquent. Le restaurant, c'était du passé, et la nouvelle boutique en ligne construite par Clickforest est devenue notre avenir. Ce qui a commencé comme une solution d'urgence s'est transformé en une magnifique boutique Shopify qui tourne bien, et en un partenariat solide avec un partenaire de confiance sur lequel je peux compter les yeux fermés. Avec le recul, c'était le bon choix. Quand le corona a forcé tous les restaurants à fermer, j'ai su immédiatement : ça va durer plus de trois semaines. Je ne voulais pas rester les bras croisés et j'ai décidé de regarder vers l'avenir. En tant que cuisinière et restauratrice, j'avais zéro expérience en marketing digital ou SEO, c'était un monde totalement inconnu pour moi. Mais grâce à Frederiek de Clickforest, j'ai appris pas à pas comment ça fonctionne. Le résultat ? Nos ventes augmentent encore chaque année. Frederiek continue d'apporter de nouvelles idées et des outils pratiques pour améliorer la boutique, je n'ai plus qu'à les mettre en pratique. Aujourd'hui, je profite à nouveau d'une qualité de vie. De plus en plus de processus sont automatisés, si bien que la boutique tourne aussi le soir alors qu'avant je m'épuisais encore en cuisine. J'ai maintenant une équipe fidèle depuis de nombreuses années, et tout ça grâce à cette décision de miser pleinement sur la boutique en ligne et de faire confiance aveuglément à Frederiek. Même aujourd'hui, nous continuons à nous développer. Notre livraison est maintenant divisée en zones, et Frederiek l'a intégrée parfaitement dans notre boutique. Mon ChatGPT a entre-temps été transformé en studio de contenu propre à Bastiano, encore une avancée intelligente grâce à lui. Si je devais attribuer des étoiles, cinq étoiles seraient bien insuffisantes. 10/10 mon ami ! Sans Frederiek, je n'y serais jamais arrivée.
Merci infiniment ! Debby Swinnen - Gérante - Bastiano
Cuisine italienne con tanto amore ❤️
Dès notre première conversation avec Frederiek de Clickforest, nous avons su que nous avions affaire à la bonne personne. Son approche est non seulement réfléchie et stratégique, mais aussi étonnamment directe, dans le meilleur sens du terme. Il a immédiatement su mettre le doigt sur des points douloureux auxquels nous n'avions pas encore pensé nous-mêmes. Frederiek possède une connaissance impressionnante et approfondie du marketing, de Shopify, de Google et de Meta. Ce qui le distingue vraiment, c'est sa capacité à intégrer toutes ces plateformes de manière transparente en un ensemble puissant. De plus, Frederiek est un homme extrêmement agréable avec qui travailler. Il est clair dans sa communication, réfléchit avec vous, est enthousiaste et en même temps réaliste. En résumé : quiconque cherche quelqu'un qui va au-delà des solutions standard et travaille de manière agréable vers le meilleur résultat ne se trompera pas chez Clickforest.
ClickForest combine l'IA, le marketing en ligne et l'e-commerce d'une façon qu'on ne trouve nulle part ailleurs. Grâce à leur approche, on voit rapidement des résultats concrets.
ClickForest livre des résultats de premier ordre ! Professionnel, innovant et toujours axé sur une croissance mesurable. Une vraie recommandation pour qui veut performer en ligne.
Très bonne collaboration avec l'équipe de Clickforest. Ils écoutent vraiment vos souhaits, anticipent de manière proactive et livrent de la qualité. Grâce à leur expertise, nous avons fait de belles avancées en ligne. À recommander absolument !
ClickForest, c'est la connaissance et le conseil sur mesure. Pas de marketing traditionnel, mais un marketing avec une idée qui contribue à une croissance efficace.
Solution tout-en-un en matière de marketing en ligne, e-commerce et IA. Agence professionnelle. Au courant de tous les derniers développements. À l'écoute du client et orienté résultats.
Un conseiller en marketing, e-commerce et IA qui sait de quoi il parle ! Approche extrêmement proactive et toujours au fait des dernières tendances. À recommander !
En tant que propriétaire d'une petite entreprise, le SEO m'a toujours semblé une distraction de mon travail, mais tout a changé lorsque j'ai commencé à collaborer avec Frederiek de ClickForest. Je suis de nature assez sceptique vis-à-vis du marketing digital, mais Frederiek a traité ma petite entreprise avec le même soin que celui qu'on attendrait d'un grand client professionnel. Au lieu de naviguer à l'aveugle, il a pris le temps de m'expliquer les bases pour que je puisse mieux comprendre mon propre site. Cette transparence m'a vraiment donné confiance et m'a fourni un nouvel ensemble d'outils précieux. Il a très bien géré le décalage horaire entre les États-Unis et l'Europe, et était toujours prêt à passer un appel quand ça m'arrangeait. Il a également travaillé directement avec mon développeur web pour finaliser les aspects techniques et les modifications on-page sans problème ni temps d'arrêt. Notre visibilité a considérablement augmenté et j'ai enfin l'impression de maîtriser notre croissance organique. Si vous vivez aux États-Unis et cherchez quelqu'un qui s'y connaît et qui se soucie vraiment de votre entreprise, je recommande chaleureusement ClickForest.
Clickforest n'est pas un simple bureau digital. Leurs conseils font vraiment la différence. Chaque recommandation semble faite sur mesure, actionnable et basée sur une véritable expérience. Ils ne poussent pas de tactiques marketing génériques ; ils prennent le temps de comprendre vos objectifs et vous offrent des conseils clairs et structurés qui produisent de vrais résultats. Les connaissances et la réflexion stratégique de l'équipe m'ont fait gagner du temps, de l'argent et bien des erreurs. Si vous cherchez un partenaire qui apporte une vraie valeur plutôt que des promesses creuses, je recommande chaleureusement Clickforest.
L'élément le plus important d'une boutique en ligne réussie et rentable est une équipe qui comprend vos besoins et vos ambitions. Avec ClickForest, vous bénéficiez d'une équipe d'experts dévoués qui vous aide à affiner le comment et le pourquoi, élabore votre stratégie avec vous et la combine avec des résultats impressionnants.
ClickForest combine efficacité digitale, innovation et valeurs humaines : l'agence idéale pour accélérer la croissance de votre entreprise tout en restant fidèle à vos besoins et objectifs.
Grâce aux conseils de Clickforest sur l'utilisation des bons outils IA, ma productivité a considérablement augmenté. Les conseils sont personnalisés et expliqués dans un langage clair. Je ne peux plus m'en passer ! Mes questions de suivi ont également reçu des réponses rapides et précises. Merci beaucoup !
Ces clients ont également attribué 5 étoiles à ClickForest sur Google