JSON-LD voor SEO: de gids voor gestructureerde data
JSON-LD is de vorm van structured data die Google aanraadt. Met sjablonen, wat site-wide hoort, welke rich results nog bestaan en wat AI ermee doet

Samenvatting
- JSON-LD is de vorm van structured data die Google aanraadt omdat ze het makkelijkst te onderhouden is; Microdata en RDFa zijn voor Google even geldig
- Google schrapte sinds 2023 onder meer de rich results voor FAQ, HowTo en het sitelinks-zoekvak; breadcrumbs verschijnen enkel nog op desktop
- Voor AI Overviews en AI Mode is volgens Google geen speciale markup nodig; Bing zegt dat gestructureerde content AI-systemen helpt, OpenAI noemt JSON-LD niet in zijn shoppinghulp
- Beheer WebSite, Organization en Person op één plek; Google heeft Organization alleen op je homepage of over-ons-pagina nodig
- Een vaste @id-strategie op basis van je canonical URL houdt de verwijzingen kloppend, ook op honderden pagina's
- Controleer site-breed met de rapporten in Search Console plus een crawler met validatie, en losse pagina's met de Rich Results Test
Veel websites hebben een JSON-LD-implementatie die langzaam een lappendeken is geworden. Organization-schema dat op elke pagina net anders staat. Inconsistente @id’s. FAQ-markup voor vragen die niemand op de pagina ziet. Het resultaat: meldingen in Search Console en markup die niemand nog durft aan te raken. Daar komt bij dat Google sinds 2023 een reeks rich results schrapte, waardoor een deel van het oude advies niets meer oplevert. In deze gids leggen we uit hoe je JSON-LD opzet zodat het schaalt, met kopieerbare sjablonen, 10 veelgemaakte fouten en een manier om alles site-breed te controleren. Structured data is een vaste bouwsteen van technische SEO, en die bouwsteen moet kloppen.
Wat is JSON-LD?
JSON-LD (JavaScript Object Notation for Linked Data) is een formaat om gestructureerde data aan een webpagina toe te voegen, zodat zoekmachines exact weten wat er op de pagina staat: een organisatie, een product, een artikel of een evenement. Je plaatst het als apart <script type="application/ld+json">-blok in de HTML, los van de zichtbare tekst, met de woordenschat van Schema.org.
Google raadt JSON-LD aan omdat het “the easiest solution for website owners to implement and maintain at scale” is. Op dezelfde pagina staat dat “all 3 formats are equally fine for Google”, zolang de markup geldig is. Microdata en RDFa zijn dus even correct. Google leest JSON-LD ook als JavaScript of een CMS-widget het in de pagina injecteert.
Schema.org beheert de woordenschat; de huidige versie is V30.1 van 16/09/2026. Meer over structured data in het algemeen staat in onze gids over structured data voor Google. Hieronder beschrijven we één vaste architectuur die ook op honderden pagina’s blijft kloppen.
Welke rich results toont Google in 2026 nog?
Google toont in 2026 nog rich results voor onder meer artikels, producten, reviews, recepten, evenementen, vacatures, video’s, lokale bedrijven, organisaties en breadcrumbs, die laatste enkel op desktop. FAQ, HowTo en het sitelinks-zoekvak zijn verdwenen, net als een reeks kleinere types. Markup voor die types blijft geldig Schema.org, maar levert in Google geen zichtbaar resultaat meer op.
| Feature | Wat veranderde | Datum |
|---|---|---|
| HowTo | Niet meer getoond | september 2023 |
| FAQ | Beperkt tot overheids- en gezondheidssites | september 2023 |
| Sitelinks-zoekvak | Niet meer beschikbaar (WebSite met SearchAction) | 29/11/2024 |
| Breadcrumb | Enkel nog op desktop | 22/01/2025 |
| ClaimReview, Course info, Estimated salary, Learning video, Special announcement, Vehicle listing | Uitgefaseerd | aangekondigd 12/06/2025 |
| Practice problem | Niet meer getoond | 06/01/2026 |
| FAQ | Volledig weg, documentatie verwijderd op 15/06/2026 | 07/05/2026 |
Bij de uitfasering van juni 2025 schreef Henry Hsu, productmanager bij Google Search: “This update won’t affect how pages are ranked.” Bij de schrappingen van 2025 en januari 2026 verdwenen die types ook uit de Rich Results Test en Search Console. Voor webshops kwam er markup bij voor loyaliteitsprogramma’s (10/06/2025) en verzendbeleid op merchant-niveau (12/11/2025).
Helpt JSON-LD om geciteerd te worden door AI-zoekmachines?
Dat is niet aangetoond. Google zegt dat je voor AI Overviews en AI Mode geen speciale structured data nodig hebt. Microsoft Bing zegt dat gestructureerde content AI-systemen helpt om je pagina te interpreteren. In OpenAI’s helpartikel over shoppen komt JSON-LD niet voor. En een Ahrefs-studie op 1.885 pagina’s zag na het toevoegen van schema geen grote stijging in AI-citaties.
“Structured data isn’t required for generative AI search, and there’s no special schema.org markup you need to add. However, it’s a good idea to continue using it as part of your overall SEO strategy, as it helps with being eligible for rich results on Google Search.”
— Google Search Central, in de gids over optimaliseren voor generatieve AI-functies (juli 2026)
Bing is positiever:
“Structured content, like schema-marked product pages, FAQs, and comparison tables, helps AI systems interpret and summarize your content more effectively. This increases the chances of your being cited, clicked, and engaged with in multi-source answers.”
— Fabrice Canel en Krishna Madhavan, Principal Product Managers bij Microsoft Bing, op de Bing Webmaster Blog (november 2025)
Het helpartikel over shoppen met ChatGPT spreekt van “structured metadata from first-party and third-party providers”, maar noemt Schema.org en JSON-LD nergens. OpenAI werkt voor producten met feeds, meer daarover in ons artikel over webshops vindbaar maken voor AI-agenten.
In de Ahrefs-studie daalden de citaties in AI Overviews met 4,6%, statistisch significant maar klein. AI Mode (+2,4%) en ChatGPT (+2,2%) waren niet te onderscheiden van nul. Ahrefs noemt zelf de grenzen, zoals een meetvenster van 30 dagen en andere wijzigingen tegelijk. JSON-LD is dus technische hygiëne. Hoe je in AI-antwoorden zichtbaar wordt, lees je bij GEO en in hoe SEO evolueert naar GEO.
Wie als KMO in Vlaanderen zichtbaar wil worden in AI-antwoorden, kan bij ClickForest terecht voor GEO.
Waarom bijna alle JSON-LD implementaties rommelig worden
JSON-LD-implementaties starten meestal goed. Een developer zet Organization op de homepage. Dan krijgen productpagina’s en blogartikels er elk hun eigen kopie bij. Voor je het weet staat dezelfde definitie op honderden pagina’s, met subtiele verschillen omdat ze op verschillende momenten zijn toegevoegd.
Symptomen van drift:
- Organization-schema met verschillende waarden. Op pagina A een logo van 200x200px, op pagina B van 400x400px, op pagina C geen.
- Inconsistente @id-fragmenten. De ene pagina gebruikt #organization, de andere #company of geen @id.
- Gemengde types zonder logica. Een contactpagina met tegelijk Service, AboutPage en ContactPage.
- Markup voor content die er niet staat. FAQ-vragen uit een template die niet op de pagina te lezen zijn.
- Zelfverwijzende lussen. WebPage.mainEntityOfPage verwijst naar zichzelf.
De oorzaak: geen scheiding tussen wat site-wide hoort en wat uniek is per pagina. Vaak is er zelfs niets: uit ons onderzoek op 200 gescande Belgische websites bleek dat op 119 van de 200 sites geen gestructureerde data stond. In een SEO-audit komt het daarom vaak als een van de eerste technische knelpunten naar boven.
De kernprincipes die alles oplossen
Vijf principes houden JSON-LD consistent: één page-level script per pagina met een @graph, een vaste @id-strategie, een strikte scheiding tussen site-wide en page-level, URL’s die exact je canonical volgen, en bij een opkuis enkel wijzigen wat echt fout is. Het is een eigen architectuurkeuze die binnen Google’s richtlijnen valt: Google’s eigen richtlijnen noemen @id als manier om items op één pagina te koppelen.
1. Eén page-level JSON-LD script per pagina
Zet alle paginaspecifieke nodes samen in één <script type="application/ld+json">-blok met een @graph-array. Je mag het site-wide en het page-level deel ook samenvoegen in één @graph via je template.
2. Stabiele @id-strategie
Elke node krijgt een @id op basis van de canonical URL plus een fragment, zoals https://example.com/seo#service of https://example.com/blog/artikel#blogpost.
3. Strikte scheiding: site-wide vs page-level
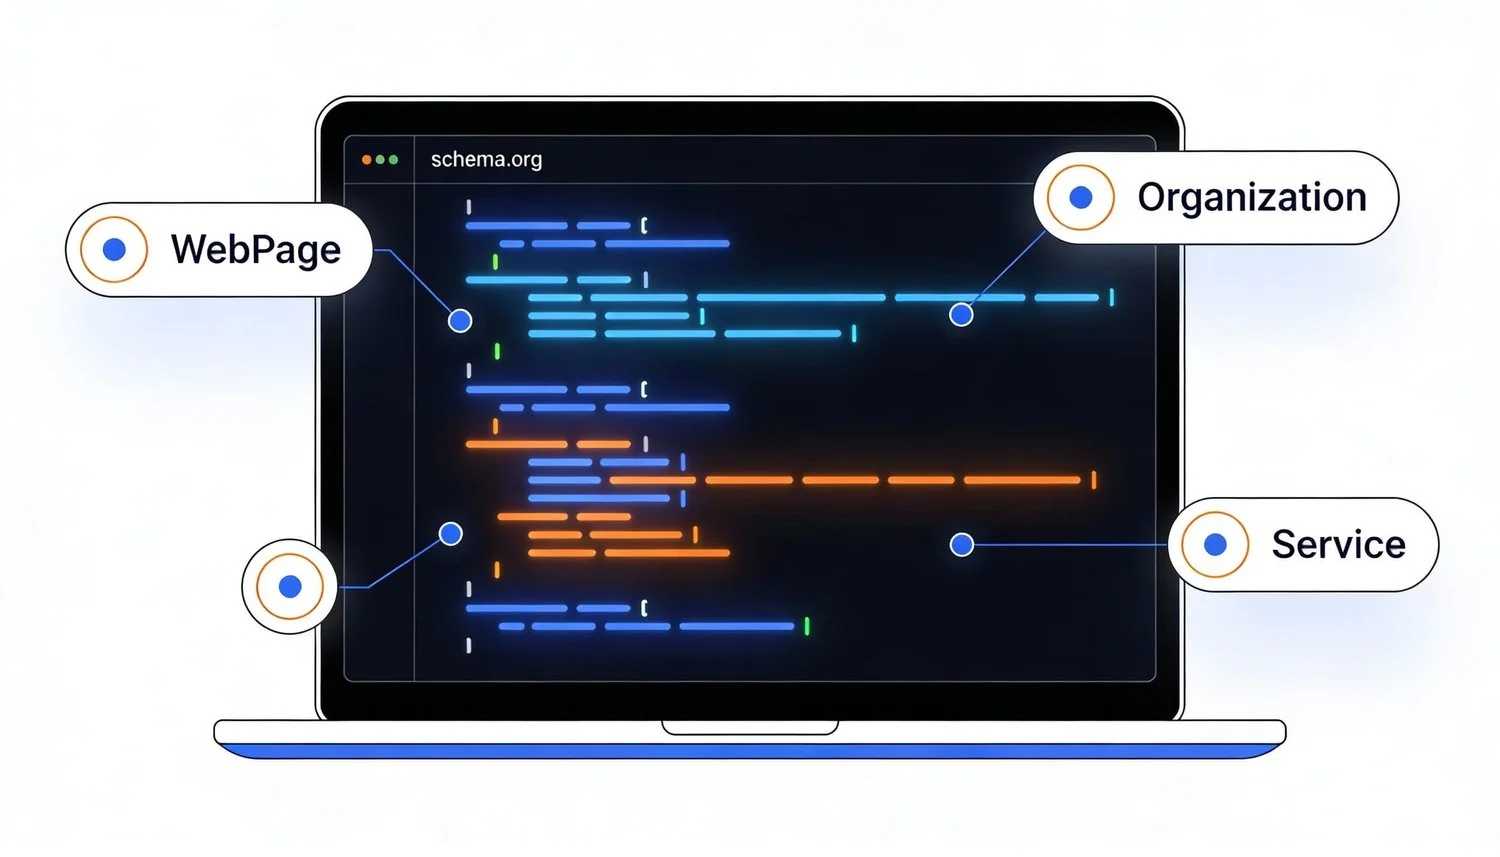
WebSite, Organization en Person definieer je op één plek. WebPage, Service, BlogPosting, BreadcrumbList en FAQPage staan in het paginascript en verwijzen naar de site-wide entiteiten via hun @id.
4. Match URLs exact met canonical
Is je canonical https://example.com/over-ons, gebruik dan exact die URL in @id en url, inclusief www of non-www en trailing slash.
5. Preserve unless invalid (bij het opschonen van bestaande implementaties)
Verander bij een opkuis enkel wat feitelijk fout is. Een description van 180 tekens of een werkende image-URL laat je staan, zo vermijd je onbedoelde neveneffecten.
”(…) Structured data won’t make your site rank better. It’s used for displaying the search features listed in developers.google.com/search/docs/… . Use it if your pages map to & are appropriate for any of those features.”
— John Mueller, Search Advocate bij Google, op Bluesky, geciteerd in Search Engine Journal (april 2025)
Wat hoort site-wide (en waarom)
Site-wide horen de gegevens die voor de hele website gelijk zijn: WebSite, Organization en eventueel een Person voor de founder of vaste auteur. Je beheert ze op één plek, in een script dat je template inlaadt. Zo verwijzen alle page-level nodes naar exact dezelfde definitie en bestaat er geen tweede versie die afwijkt.
Google heeft Organization zelf niet op elke pagina nodig:
“We recommend placing this information on your home page, or a single page that describes your organization, for example the about us page. You don’t need to include it on every page of your site.”
— Google Search Central, in de documentatie over Organization-structured data (september 2026)
Dat botst niet met een site-wide @graph, want het probleem zit in kopieën die van elkaar afwijken. Twee opties zijn geldig: de volledige Organization enkel op homepage of over-ons-pagina met elders @id-verwijzingen, of een site-wide include uit één bron. Kies er één.
Welke entities horen site-wide:
WebSite: name, url, publisher (het @id van Organization) en inLanguage. Een potentialAction voor het zoekvak hoef je niet toe te voegen, want Google toont het sitelinks-zoekvak sinds 29/11/2024 niet meer.
Organization: name, url, logo en sameAs, optioneel contactPoint en address. Google raadt het meest specifieke subtype aan dat bij je organisatie past. Webshops zetten hier ook hun retour- en verzendbeleid.
Person (optioneel): name, url, sameAs (LinkedIn, X) en worksFor (het @id van Organization).
Wat NIET site-wide hoort: Service, BlogPosting, BreadcrumbList, FAQPage, Product en ProductGroup. Die zijn uniek per pagina.
Start minimaal: contactPoint enkel bij een echt klantenservicenummer, address enkel bij een relevante fysieke locatie.
Overzichtstabel: wat hoort waar
| Entity / Type | Site-wide script? | Page-level script? | Waarom |
|---|---|---|---|
| WebSite | ✓ | - | Eén website, één definitie |
| Organization | ✓ | - | Eén bron voor je bedrijfsgegevens |
| Person | ✓ | - | Founder of auteur consistent |
| WebPage | - | ✓ | Uniek per pagina |
| Service | - | ✓ | Per dienstpagina |
| BlogPosting | - | ✓ | Uniek per artikel |
| BreadcrumbList | - | ✓ | Pad varieert per pagina |
| FAQPage | - | ✓ | Per pagina, geen rich result meer |
| ImageObject (primary) | - | ✓ | Hoofdafbeelding per pagina |
| Product / ProductGroup | - | ✓ | Per product, varianten in een ProductGroup |
Site-wide JSON-LD template (copy-paste)
Dit sjabloon definieert WebSite, Organization en Person in één @graph. Plaats het via een global include in de <head> van elke pagina, zodat elke @id-verwijzing op die pagina oplost, of beperk het tot homepage en over-ons-pagina als je voor die optie kiest. Vervang de placeholders en schrap wat je niet echt hebt.
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "WebSite",
      "@id": "https://example.com/#website",
      "url": "https://example.com",
      "name": "[WEBSITE_NAME]",
      "inLanguage": "nl-BE",
      "publisher": {
        "@id": "https://example.com/#organization"
      }
    },
    {
      "@type": "Organization",
      "@id": "https://example.com/#organization",
      "name": "[ORGANIZATION_NAME]",
      "url": "https://example.com",
      "logo": {
        "@type": "ImageObject",
        "url": "[LOGO_URL]"
      },
      "sameAs": [
        "[SOCIAL_URL_1]",
        "[SOCIAL_URL_2]",
        "[SOCIAL_URL_3]"
      ]
    },
    {
      "@type": "Person",
      "@id": "https://example.com/#founder",
      "name": "[FOUNDER_NAME]",
      "url": "https://example.com/over-ons",
      "sameAs": [
        "[LINKEDIN_URL]"
      ],
      "worksFor": {
        "@id": "https://example.com/#organization"
      }
    }
  ]
}
Vervang de placeholders:
- [WEBSITE_NAME] en [ORGANIZATION_NAME]: je websitenaam en formele bedrijfsnaam
- [LOGO_URL]: volledige URL naar je logo, minstens 112x112px volgens Google
- [SOCIAL_URL_1/2/3]: officiële profielen zoals LinkedIn, Facebook, Instagram of X
- [FOUNDER_NAME] en [LINKEDIN_URL]: naam en LinkedIn van de founder
Vervang “Organization” door een specifieker subtype als dat past. Het Person-blok neem je alleen op als je bedrijf founder-led is of op thought leadership steunt.
Page-level JSON-LD voor gewone pagina’s (services, locaties, etc.)
Voor gewone pagina’s zoals diensten, over ons, contact en locaties volstaat een kleine set nodes: altijd een WebPage, een Service als het echt een dienstpagina is, en optioneel een BreadcrumbList en een FAQPage. Elke node verwijst via @id naar de site-wide WebSite en Organization, zodat je bedrijfsgegevens nergens herhaald worden.
Linking cheatsheet per pagetype
| Pagetype | Van node | Property | Naar node | Voorbeeld @id |
|---|---|---|---|---|
| Service page | WebPage | isPartOf | WebSite | https://example.com/ |
| Service page | WebPage | mainEntity | Service | https://example.com/seo |
| Service page | Service | provider | Organization | https://example.com/ |
| Service page | Service | mainEntityOfPage | WebPage | https://example.com/seo |
| Blog post | WebPage | isPartOf | WebSite | https://example.com/ |
| Blog post | WebPage | mainEntity | BlogPosting | https://example.com/blog/seo-tips |
| Blog post | BlogPosting | mainEntityOfPage | WebPage | https://example.com/blog/seo-tips |
| Blog post | BlogPosting | author | Person | https://example.com/ |
| Blog post | BlogPosting | publisher | Organization | https://example.com/ |
Canonical template voor service pagina:
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "WebPage",
      "@id": "https://example.com/seo#webpage",
      "url": "https://example.com/seo",
      "name": "SEO diensten",
      "description": "SEO optimalisatie voor bedrijven in België.",
      "isPartOf": {
        "@id": "https://example.com/#website"
      },
      "mainEntity": {
        "@id": "https://example.com/seo#service"
      }
    },
    {
      "@type": "Service",
      "@id": "https://example.com/seo#service",
      "serviceType": "SEO optimalisatie",
      "name": "SEO diensten",
      "description": "Technische SEO, content optimalisatie en linkbuilding.",
      "provider": {
        "@id": "https://example.com/#organization"
      },
      "areaServed": {
        "@type": "Country",
        "name": "België"
      },
      "mainEntityOfPage": {
        "@id": "https://example.com/seo#webpage"
      }
    },
    {
      "@type": "BreadcrumbList",
      "@id": "https://example.com/seo#breadcrumbs",
      "itemListElement": [
        {
          "@type": "ListItem",
          "position": 1,
          "name": "Home",
          "item": "https://example.com"
        },
        {
          "@type": "ListItem",
          "position": 2,
          "name": "SEO",
          "item": "https://example.com/seo"
        }
      ]
    }
  ]
}
Note over BreadcrumbList: neem breadcrumbs alleen op als je ze toont of een hiërarchie consequent aanhoudt. Google toont ze sinds 22/01/2025 enkel nog in de desktopresultaten. Productpagina’s vragen eigen markup, die we verderop bespreken bij webshops.
Page-level JSON-LD voor blogartikels
Een blogartikel krijgt een WebPage en een BlogPosting, met optioneel een BreadcrumbList en een FAQPage als de vragen zichtbaar op de pagina staan. De BlogPosting verwijst via mainEntityOfPage naar de WebPage, via author naar de auteur en via publisher naar je bedrijf. Zo blijft elk artikel gekoppeld aan dezelfde site-wide entiteiten.
Canonical template voor blog post:
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "WebPage",
      "@id": "https://example.com/blog/seo-tips#webpage",
      "url": "https://example.com/blog/seo-tips",
      "name": "SEO tips voor 2026",
      "description": "Overzicht van praktische SEO tips.",
      "isPartOf": {
        "@id": "https://example.com/#website"
      },
      "mainEntity": {
        "@id": "https://example.com/blog/seo-tips#blogpost"
      }
    },
    {
      "@type": "BlogPosting",
      "@id": "https://example.com/blog/seo-tips#blogpost",
      "headline": "SEO tips voor 2026",
      "description": "Overzicht van praktische SEO tips.",
      "image": "https://example.com/images/seo-tips-header.jpg",
      "datePublished": "2026-01-15T10:00:00+01:00",
      "dateModified": "2026-01-20T14:30:00+01:00",
      "author": {
        "@type": "Person",
        "@id": "https://example.com/#founder",
        "name": "[FOUNDER_NAME]",
        "url": "https://example.com/over-ons"
      },
      "publisher": {
        "@id": "https://example.com/#organization"
      },
      "mainEntityOfPage": {
        "@id": "https://example.com/blog/seo-tips#webpage"
      }
    },
    {
      "@type": "BreadcrumbList",
      "@id": "https://example.com/blog/seo-tips#breadcrumbs",
      "itemListElement": [
        {
          "@type": "ListItem",
          "position": 1,
          "name": "Home",
          "item": "https://example.com"
        },
        {
          "@type": "ListItem",
          "position": 2,
          "name": "Blog",
          "item": "https://example.com/blog"
        },
        {
          "@type": "ListItem",
          "position": 3,
          "name": "SEO tips voor 2026",
          "item": "https://example.com/blog/seo-tips"
        }
      ]
    }
  ]
}
De author draagt naast het @id ook naam en url, met exact dezelfde waarden als je site-wide Person, zodat de auteur ook op zichzelf herkenbaar is. Zet dateModified enkel bij een echte inhoudelijke wijziging.
ID en URL strategie die bulk-proof is
Een @id is een vaste naam voor een node: je canonical URL plus een fragment zoals #webpage of #service. Genereer het met dezelfde logica die je canonical URL maakt, dan kloppen de verwijzingen ook op sites met honderden product- of blogpagina’s. Eén afwijkende slash of een www te veel breekt de koppeling tussen twee nodes.
Strikte pattern voor @id fragmenten:
- WebPage: [CANONICAL_URL]#webpage
- Service: [CANONICAL_URL]#service
- BlogPosting: [CANONICAL_URL]#blogpost
- BreadcrumbList: [CANONICAL_URL]#breadcrumbs
- FAQPage: [CANONICAL_URL]#faq
- ImageObject (primary): [CANONICAL_URL]#primaryimage
Schrijf fragmenten in kleine letters (#webpage) en gebruik voor hetzelfde type overal hetzelfde fragment, bijvoorbeeld #service op elke dienstpagina. Bij 200 productpagina’s genereer je de @id’s in je template. Shopify heeft daarvoor het Liquid-filter structured_data, dat een product of artikel omzet naar Schema.org-markup.
Welke JSON-LD heeft een webshop nodig?
Een webshop heeft Product-markup nodig, en voor producten in meerdere maten of kleuren een ProductGroup met de varianten als Product. Google onderscheidt product snippets voor pagina’s waar je niet kunt kopen en merchant listings voor pagina’s waar dat wel kan; die laatste dragen meer details, zoals verzending en retourbeleid. Reviews en aggregateRating zijn niet verplicht.
Google raadt aan om markup en een productfeed te combineren: “Providing both structured data on web pages and a Merchant Center feed maximizes your eligibility to experiences and helps Google correctly understand and verify your data.”
Voor Shopify-webshops maakt het structured_data-filter van een product zonder varianten een Product en van een product met varianten een ProductGroup. Retour-, verzend- en loyaliteitsbeleid zet je op merchant-niveau onder Organization, met hasMerchantReturnPolicy, hasShippingService en hasMemberProgram; verzendbeleid kan ook in Search Console. Volgens OpenAI zit de productdata van Shopify-merchants al in ChatGPT via Shopify Catalog, zonder extra werk.
Kijk bij een Shopify-webshop eerst wat het thema al genereert voor je markup toevoegt: twee Product-nodes voor hetzelfde product zijn een klassiek symptoom van drift. Meer in onze SEO-checklist voor Shopify en e-commerce SEO-tips.
Voor Shopify-webshops in Vlaanderen neemt ClickForest de structured data mee in een SEO-audit.
Veelgemaakte fouten (met fixes)
De meeste JSON-LD-fouten komen terug op dubbele definities, verwijzingen die niet kloppen en markup die niet overeenkomt met de zichtbare pagina. Syntaxfouten breken het hele script, de andere fouten maken je signalen onduidelijk of kosten je rich results. Hieronder staan de 10 fouten die het vaakst voorkomen, eerst als overzicht en daarna met uitleg en fix.
Quick reference: 10 fouten overzicht
| Fout | Herkenning | Impact | Fix |
|---|---|---|---|
| Organization dupliceren | Elke pagina eigen Organization | Kopieën groeien uit elkaar | Eén bron, elders via @id |
| Types mixen | BlogPosting + Service op zelfde URL | Ambiguïteit | Kies één primair type |
| Self-referencing loop | WebPage.mainEntityOfPage → zichzelf | Circulaire verwijzing | Verwijder uit WebPage |
| Onzichtbare content markeren | FAQ of reviews in schema die niemand ziet | Manual action: rich results kwijt | Markeer enkel zichtbare content |
| Onbewezen claims | "500+ klanten" zonder bewijs | Misleidende markup | Enkel verifieerbare feiten |
| Inconsistente URLs | Mix van www/non-www en trailing slash | Breekt verwijzingen | Eén format, gelijk aan canonical |
| Over-gevulde sameAs | Directories in sameAs | Verwatert je echte profielen | Vuistregel: 3-5 officiële profielen |
| Meerdere scripts | 4+ losse JSON-LD-blokken | Moeilijk te onderhouden | Hoogstens 2 scripts met @graph |
| JSON syntax fouten | Trailing comma's, smart quotes | Breekt JSON parsing | Valideer met JSONLint |
| Andere scripts wijzigen | GA-script aangepast bij JSON-LD-edit | Kan tracking breken | Raak enkel het JSON-LD-blok aan |
Uitgebreide uitleg per fout
1. Organization schema op elke pagina dupliceren. Elke pagina krijgt een eigen Organization, en die kopieën groeien uit elkaar. Fix: één bron, en page-level nodes verwijzen via {"@id": "https://example.com/#organization"}.
2. BlogPosting en Service op dezelfde URL mixen. Kies één primair type: een artikel over een dienst is een BlogPosting, een dienstpagina een Service met WebPage.
3. WebPage.mainEntityOfPage verwijst naar zichzelf.
{
  "@type": "WebPage",
  "@id": "https://example.com/seo#webpage",
  "mainEntityOfPage": {
    "@id": "https://example.com/seo#webpage"
  }
}
mainEntityOfPage verwijst van een Service of BlogPosting naar de WebPage waar die op staat. Fix: haal het uit de WebPage-node.
4. Markup voor content die niet op de pagina staat. Google verbiedt markup voor content die lezers niet zien, zoals FAQ-vragen uit een template of reviews die nergens staan. Het gevolg staat in dezelfde richtlijnen: “A structured data manual action means that a page loses eligibility for appearance as a rich result; it doesn’t affect how the page ranks in Google web search.”
5. Description met claims die je niet kunt staven. “500+ tevreden klanten” zonder die klanten is misleidende markup. Gebruik alleen bewijsbare feiten.
6. URL formats halverwege site wijzigen. De homepage gebruikt https://example.com, subpagina’s https://www.example.com/. Zo breken de verwijzingen tussen entiteiten. Kies één format, gelijk aan je canonical.
7. Over-gevulde sameAs met willekeurige bronnen. Gebruik alleen officiële profielen en eventueel Wikipedia. Onze vuistregel: 3 tot 5 URL’s die je zelf beheert.
8. Meerdere JSON-LD scripts zonder reden. Vier losse blokken vergroten de kans op duplicatie. Houd het bij één site-wide en één page-level script, of één samengevoegde @graph.
9. Broken JSON door syntax fouten. JSON is streng. Drie fouten komen het vaakst voor.
A. Trailing comma’s: JSON staat geen komma na de laatste property toe.
{
  "name": "Test",
  "url": "https://example.com",
}
B. Smart quotes: JSON vereist rechte dubbele aanhalingstekens rond keys en strings. De typografische versie die Word en Google Docs automatisch maken, breekt de parsing. Een typografische apostrof binnen een string mag wel.
{
  “name”: “Test Service”
}
C. Quotes binnen strings escapen: een quote binnen een string krijgt een backslash ervoor.
{
  "name": "Test "Premium" Service"
}{
"name": "Test \"Premium\" Service"
}Een validator zoals JSONLint vangt al deze syntaxfouten voor publicatie.
10. Andere scripts in pagina wijzigen bij JSON-LD edit. Wie JSON-LD toevoegt, raakt soms per ongeluk het Google Analytics-script aan. Test na deployment of tracking nog werkt.
Hoe controleer je JSON-LD op je hele site?
Site-breed controleer je JSON-LD met twee lagen. De rich-result-rapporten in Google Search Console tonen gratis wat Google over je hele site vindt. Een crawler met ingebouwde validatie controleert elke URL tegen Schema.org en de vereisten van Google. De Rich Results Test en de Schema Markup Validator houd je voor losse pagina’s.
De rapporten in Search Console hebben grenzen. Google schrijft dat ze “aren’t a comprehensive list of all detected items”, de detailtabel stopt bij 1.000 rijen, en je ziet enkel types die Google ondersteunt, dus geen FAQ of HowTo meer. Volg ze ook na de livegang, want templates kunnen markup breken.
Een crawler vult dat aan: Screaming Frog SEO Spider kan bijvoorbeeld “audit and validate structured data against Schema.org specifications and Google’s rich result feature requirements” en bundelt de fouten van de hele site in één rapport, met een betalende licentie. Hun documentatie dateert van 2024, dus check welke validaties nog tellen. Bing Webmaster Tools toont per URL de markup die Bing vindt.
Toont je SEO-plugin schema enkel per pagina, dan hoef je niet te wisselen: combineer Search Console met een crawl. Voor de AI-kant is een GEO-audit de logische stap.
Checklist voor publicatie
Controleer voor je JSON-LD live zet of de syntax klopt, of elk type past bij de pagina, of elke @id-verwijzing oplost en of alles in de markup ook zichtbaar is. Rol daarna gefaseerd uit. Google schrijft in zijn featuregidsen zelf, bijvoorbeeld in die over software-apps: “Deploy a few pages that include your structured data and use the URL Inspection tool to test how Google sees the page.”
- JSON-syntax gevalideerd met JSONLint
- Schematype past bij de pagina (Service voor een dienst, BlogPosting voor een artikel)
- Alle @id-verwijzingen lossen op
- Getest met de Rich Results Test en de Schema Markup Validator, zonder fouten
- Markup komt overeen met de zichtbare content
- URLs exact zoals de canonical (www/non-www en trailing slash)
- dateModified bijgewerkt na een inhoudelijke wijziging
- Geen markup meer voor geschrapte features zoals het sitelinks-zoekvak
- Gefaseerd uitrollen; onze vuistregel is eerst 5 pagina’s, 48 uur opvolgen en dan verder
Waar begin je met het opschonen van je JSON-LD?
Begin bij de site-wide entiteiten: één Organization, één WebSite en eventueel één Person, op één plek beheerd. Leg daarna per paginatype een sjabloon vast, valideer het en rol het gefaseerd uit. Steek geen tijd meer in markup voor features die Google niet meer toont, en volg na de uitrol de rapporten in Search Console op.
Structured data werkt het best samen met degelijk keyword research, conversie-optimalisatie, GEO-strategieën en de aanpak uit ons artikel over SEO en AI combineren. ClickForest controleert de structured data van KMO’s en webshops in Vlaanderen als onderdeel van een SEO-audit of een volledige website-audit. Wil je weten hoe jouw JSON-LD ervoor staat? Neem contact op.

Meer organische zichtbaarheid, minder afhankelijkheid van betaalde advertenties
Wil je in 2 minuten weten hoe je site scoort op SEO en vindbaarheid? Doe de gratis SEO-GEO scan of bekijk onze SEO-diensten
Bespreek je uitdaging direct met Frederiek: Plan een gratis strategiegesprek of stuur ons een berichtje
Liever mailen? Stuur je vraag naar frederiek@clickforest.com of bel +32 473 84 66 27
Strategie zonder actie blijft theorie. Laten we je volgende stap samen zetten.
Veelgestelde vragen
Nee. Google's John Mueller zegt dat structured data je site niet beter laat ranken: het dient om zoekfuncties zoals rich results te tonen. Zelfs een manual action kost volgens Google enkel de geschiktheid voor rich results. Behandel JSON-LD daarom als technische hygiëne naast sterke content en autoriteit. Een SEO-audit van ClickForest voor KMO's in Vlaanderen controleert onder meer de structured data.
Niet altijd. BreadcrumbList is zinvol als je breadcrumbs echt toont op je pagina's of een duidelijke hiërarchie consequent aanhoudt. Google toont breadcrumbs sinds 22/01/2025 enkel nog in de desktopresultaten, dus op mobiel levert de markup geen zichtbaar resultaat op.
Definieer elke auteur als aparte Person met een eigen @id, bijvoorbeeld #author-frederiek en #author-jan. In de BlogPosting verwijs je naar de juiste auteur, met naam en url erbij. Wisselen de auteurs vaak, dan definieer je de Person per artikel in plaats van site-wide.
Voor Google niet meer: FAQ rich results verschijnen sinds 07/05/2026 niet meer en de documentatie verdween op 15/06/2026. FAQPage blijft een geldig Schema.org-type, en Bing zegt dat gestructureerde content zoals FAQ's AI-systemen helpt. Gebruik het enkel als de vragen en antwoorden zichtbaar op de pagina staan.
Kies het type dat bij je pagina past, vul de vereiste properties in volgens de documentatie van Google en test de code met de Rich Results Test. Zet daarna eerst enkele pagina's live en bekijk ze met de URL-inspectie in Search Console. Bouw de sjablonen daarna in je template zelf, zodat elke nieuwe pagina ze automatisch krijgt. ClickForest neemt die controle voor KMO's en webshops in Vlaanderen mee in een SEO-audit.
Bronnen en referenties
Officiële Google-documentatie:
- Google Search Central - Introduction to structured data markup · https://developers.google.com/search/docs/appearance/structured-data/intro-structured-data
- Google Search Central - General structured data guidelines · https://developers.google.com/search/docs/appearance/structured-data/sd-policies
- Google Search Central - Structured data markup that Google Search supports (oktober 2026) · https://developers.google.com/search/docs/appearance/structured-data/search-gallery
- Google Search Central - Organization structured data · https://developers.google.com/search/docs/appearance/structured-data/organization
- Google Search Central - Product structured data · https://developers.google.com/search/docs/appearance/structured-data/product
- Google Search Central - Product variants (ProductGroup) · https://developers.google.com/search/docs/appearance/structured-data/product-variants
- Google Search Central - Merchant shipping policy · https://developers.google.com/search/docs/appearance/structured-data/shipping-policy
- Google Search Central - changelog: afvoering FAQ rich results (mei-juni 2026) en eerdere schrappingen · https://developers.google.com/search/updates
- Google Search Central Blog - Simplifying the search results page (juni 2025) · https://developers.google.com/search/blog/2025/06/simplifying-search-results
- Google Search Central - Software app structured data (stappenplan: eerst enkele pagina's live) · https://developers.google.com/search/docs/appearance/structured-data/software-app
Structured data en AI-zoekmachines:
- Google Search Central - Optimizing for generative AI features on Search (juli 2026) · https://developers.google.com/search/docs/fundamentals/ai-optimization-guide
- Google Search Central - AI features and your website · https://developers.google.com/search/docs/appearance/ai-features
- Bing Webmaster Blog - How AI search is changing the way conversions are measured (november 2025) · https://blogs.bing.com/webmaster/2025/11/How-AI-Search-Is-Changing%E2%80%AFthe%E2%80%AFWay%E2%80%AFConversions%E2%80%AFare-Measured/
- OpenAI Help - Shopping with ChatGPT search · https://help.openai.com/en/articles/11128490-shopping-with-chatgpt-search
- Ahrefs - We Tracked 1,885 Pages Adding Schema. AI Citations Barely Moved. (mei 2026) · https://ahrefs.com/blog/schema-ai-citations/
Schema.org:
- Schema.org - Releases (V30.1, september 2026) · https://schema.org/docs/releases.html
- Schema.org - Organization type specificatie · https://schema.org/Organization
- Schema.org - FAQPage type specificatie · https://schema.org/FAQPage
Validatie en controle:
- Google Rich Results Test · https://search.google.com/test/rich-results
- Schema Markup Validator · https://validator.schema.org/
- Search Console Help - Rich result status reports · https://support.google.com/webmasters/answer/7552505
- Screaming Frog - Structured data testing and validation · https://www.screamingfrog.co.uk/seo-spider/tutorials/structured-data-testing-validation/
- Bing Webmaster Blog - Introducing the URL Inspection tool (september 2020) · https://blogs.bing.com/webmaster/2020/9/Introducing-the-Bing-Webmaster-Tools-URL-Inspection-Tool/
- Shopify - Liquid-filter structured_data · https://shopify.dev/docs/api/liquid/filters/structured_data
- JSONLint · https://jsonlint.com
Bronnen van citaten:
- John Mueller, in Search Engine Journal (april 2025) · https://www.searchenginejournal.com/google-confirms-that-structured-data-wont-make-a-site-rank-better/544433/